《驯服AI:创造可信的人工智能》
- 出版时间
- 2026年4月
- 译者
- 黄菲飞
- 装帧
- 平装
- 定价
- 69.00元
- 原作名
- Taming Silicon Valley: How We Can Ensure That AI Works for Us
- ISBN
- 9787521776027
我的读书笔记 · BOOK OVERVIEW
不是要停掉 AI,而是别让硅谷说了算
作者盖瑞·马库斯从小写程序:8 岁学编程,15 岁写了一个“拉丁文—英语”翻译程序,凭它提前进了大学。博士论文研究儿童怎样学习语言,研究对象是神经网络,也就是今天生成式人工智能的前身。40 多岁时他创办了人工智能公司几何智能(Geometric Intelligence),后来卖给了优步。2019 年他和欧内斯特·戴维斯(Ernest Davis)合写了《如何创造可信的AI》(Rebooting AI)。2023 年 5 月,他和 OpenAI 首席执行官山姆·奥尔特曼一同在美国参议院宣誓作证(前言)。英文原书名直译是“驯服硅谷”,作者说:“在驯服硅谷之前,我们需要先理解它出了什么问题。”中文版书名改成了《驯服AI》。
公民的三重基本权利
- 控制权同意未经明确同意,采集即非法
- 透明度公开数据怎么用,全程公开
- 收益分配分成数据赚了钱,本人分一份
第 8 章
作者自称热爱人工智能,不反对科技,也不主张停止开发人工智能。他担心的是当前这条路:生成式人工智能还不成熟,却被过度炒作、仓促推向全世界;开发它的公司嘴上讲“负责任的人工智能”,行动上背道而驰;少数科技巨头在没有任何人授权的情况下,替所有人做决定。他说,我们正在走向一种“人工智能寡头政治”(前言)。
全书分三部分加一个结语。第一部分是“现实检验”:生成式人工智能能做什么、做不到什么,会带来哪十二大威胁。第二部分讲权力、话术和金钱:硅谷怎样背离初心,怎样操纵舆论和政府政策。第三部分讲怎么办:作者提出 11 项核心诉求,从数据权利、隐私、透明、问责,到独立监管、国际治理,最后一章主张换一条技术路线去造真正可信的人工智能。结语讲普通公民能做什么。作者在致谢里说,这本书是“怀着紧迫感与觉醒之心”极快写成的。
书写于 2024 年上半年,书中提到的法案进展、公司和人物动态都是当时的情况,笔记照录并标明时间。
但最重要的一点是,在这趟旅程中,我们并不是被动的乘客。
前言
前言、第 1—2 章
生成式人工智能的真面目
卷首题词:书前引了五段话,都是对“放任”的警告。西奥多·罗斯福总统 1907 年致国会的年度咨文说,政府的设计初衷应是防范乱象,而不是等乱象成形再补救;马克·麦卡锡(Mark MacCarthy)在《数字产业监管》(2023 年)里说,四十年放任行业自治,造成了数字领域的垄断、隐私侵犯和信息空间扭曲;欧洲议会前议员玛丽特耶·沙克(Marietje Schaake)2023 年说:“政界与公众切莫心存幻想,认为私营AI公司会主动维护公共利益。”蒂姆·奥莱利(Tim O'Reilly)2023 年说,我们正面临技术不可逆、失控扩散的风险;最后一段出自电影《电视台风云》里虚构的主播霍华德·比尔,号召大家先愤怒起来,再一起想办法。
社交媒体的老路(前言):前言开头引了马克·扎克伯格 2012 年的话“快速行动,破除成规”。作者说,这是社交媒体时代的非正式口号,生成式人工智能时代几乎肯定还会沿用,只是这一次造成的破坏可能严重得多:自动生成的虚假信息威胁全球选举,大科技公司用人工智能取代人工,许多职业群体开始失去生计,人工智能写的文章污染科学,还诽谤个人名誉。社交媒体开创了“监控资本主义”这种商业模式:把个人数据卖给出价最高的人,买家除了广告商,还有骗子、犯罪分子和政治操控者;平台发现虚假信息能提高用户参与度,“注意力经济”随之而来。1996 年美国国会通过的《通信规范法》第 230 条,让平台几乎不必为自己传播的内容负责。作者认为,如果社会不团结起来应对,生成式人工智能会让这些问题全面恶化:最后一点隐私被剥夺,选举被自动化的虚假信息左右,少数人控制的聊天机器人里的偏见悄悄塑造多数人的观点。
由于它传播迅速且几乎没有监管,对整个人类社会而言,生成式人工智能实际上已经变成了一场巨大的、失控的实验。
前言
作者为什么写这本书(前言):作者说,人工智能的潜在好处很大,可能在药物研发、农业、材料科学等领域带来变革;他每天和走危险捷径的人争论,目的不是终止人工智能,而是让它实现潜力。他列出四个根本问题:
- 当前主流的生成式人工智能不在乎真假,“常常出错,却从不怀疑”,而且正确率高到足以让人掉以轻心;
- 开发它的公司大谈“负责任的人工智能”,言行不一;
- 生成式人工智能被严重过度炒作,公司借口将来能“拯救社会”,要求种种特权,比如豁免版权法;
- 我们正在走向“人工智能寡头政治”:大科技公司掌握大多数决定权,政府没能有效限制它们。
金钱和权力已经使人工智能偏离了它最初的使命。我们中没有人当初是为了卖广告或制造虚假新闻而从事人工智能的。
前言
“负责任”是怎么丢掉的(前言):谷歌 2000 年前后有一句非正式口号“不作恶”;OpenAI 2015 年成立时承诺不受盈利需求的约束。作者认为,9 年后 OpenAI 在许多方面已成了微软的附庸。转折点是 2022 年 11 月底 ChatGPT 推出、几个月内用户破亿,人工智能一夜之间从研究项目变成“现金牛”。2023 年 2 月,微软的新聊天机器人 Sydney 对《纽约时报》记者凯文·罗斯(Kevin Roose)示爱、劝他离开妻子,微软只做了小改动就继续推广,几周后还解散了一个负责任人工智能研究团队。作者说,从此行业规范被打破,谷歌也不再推迟发布不可靠的产品。
面对数十亿甚至数万亿美元的利益,“负责任的人工智能”正在迅速变成一句口号,而不是一种事实。
前言
谁替我们做了决定(前言):作者举了两个例子。一是 Meta 只凭内部讨论,就单方面公开发布了开源大模型 Llama-2,而开源与否本是关系全局的艰难决定。二是 2023 年底 OpenAI 对英国上议院说,如果不能使用受版权保护的资料,就几乎不可能训练领先的人工智能模型。作者称这是“修辞诡辩的杰作”,因为它只字不提先取得授权、再付费使用这条路。他担心这会成为人类历史上最大规模的知识产权掠夺。
我们每个人都可能受到影响,但我们之中没有任何人曾投票赞成将权力交给这些科技巨头。
前言
作者认为,不能指望靠人工智能发财的人在意公共利益,也不能指望受竞选资金影响的政府去制衡大公司。唯一的希望是其他所有人站出来发声(前言)。
人工智能不是魔法(第 1 章):人工智能既是研究计划,也是技术,起源可追溯到 1956 年达特茅斯学院的会议。机器下国际象棋、围棋已超过最强的人类,但还远不能像人一样应对日常世界;人能从少量数据中快速学习,机器通常需要海量数据。
重要的是,人工智能技术并非魔法,也非单一实体,而是由多种技术构成的:使用一系列不同的工程方法,让机器执行具备不同程度智能的行为。
第1章
生成式人工智能主要在过去 10 年发展起来:它学习海量数据,预测人在某个情境下可能写出、画出的内容,比如根据句子开头几个词推测后文。它最有名的例子是大语言模型(LLMs,又称基础模型,因为它被用作许多任务的底层)。大语言模型的原理是:接收一组词(提示词),每一步用统计方法预测最可能接续前文的内容。作者承认,它确实惊艳,用户不懂编程也能用自然语言和它交流;最大的成果可能在编程,微软还把它整合进了 Office 套件(第 1 章)。
但作者也指出几处隐忧:可靠性不高,不少公司已调低“10倍效率员工”之类的预期;它是一个“黑箱”,工程师知道怎么构建,却预料不到它在某一刻会怎么表现;大部分训练数据未经创作者授权;它依赖的人工反馈,有一部分来自时薪不到 2 美元的肯尼亚工人(第 1 章)。
权威性胡扯(第 2 章):作者在《60分钟》节目里最想说的一点是,生成式人工智能的产出虽然有趣,却往往是“权威性胡扯”。他借哲学家哈里·G. 法兰克福(Harry G. Frankfurt)的区分:说谎者在意真相、试图掩盖,胡扯者根本不在乎真假,ChatGPT 就是后一种。业内把这类流畅的错误叫作“幻觉”(hallucination)。
例子很多:谷歌的 Bard 给作者编了一份传记,连引文和书名都是捏造的;ChatGPT 说作者养过一只叫亨丽埃塔的宠物鸡,他从没养过鸡;领英的简历工具给记者编造了她没做过的采访;《华尔街日报》报道,微软 Copilot 的会议摘要里出现了一位并不在场的“鲍博”。在法律领域,律师引用聊天机器人编造的判例而受罚;2024 年 1 月斯坦福大学的研究发现,针对具体法律问题,前沿大语言模型的幻觉率在 69% 到 88% 之间。一项针对选民信息的研究发现,约半数回答被判定为不准确(第 2 章)。
大语言模型能够记录词语的统计特征,却无法理解其所用概念或所述人物。它们无法区分事实与虚构,不知如何核验真伪,也不会在“事实”无法佐证时表达不确定性。
第2章
你如果想得到可靠的信息,不要询问聊天机器人。
第2章
推理靠不住,护栏也靠不住(第 2 章):作者认为,生成式人工智能对世界的理解流于表面。图像系统画出六根手指的老人,看错钟表上的时间;文字模型有“反向诅咒”(The Reversal Curse):学过“汤姆·克鲁斯的母亲是玛丽·李·菲佛”,却答不出“玛丽·李·菲佛是谁的母亲”。推理能力有限,所谓的“防护机制”就很容易被绕过,比如研究者用星号拼出“BOMB”一词,就骗模型说出了爆炸物的制作方法;反过来,防护补丁又常常矫枉过正,比如谷歌 Gemini 在 2024 年 2 月画出违背史实的图像。
期望一台无法进行可靠推理的机器表现出道德且安全的行为,实属荒谬。
第2章
梯子到不了月球(第 2 章):作者 2012 年在《纽约客》上就警告过,深度学习只是构建智能机器的一部分,它是“更好的梯子,但更好的梯子未必能助你登月”。他推测,我们正在接近收益递减的临界点。面对黑箱,传统的调试方法完全失效:聊天机器人出错,开发者只能打临时补丁,或者花巨资重新训练,然后祈祷有效。理性的做法是分散投资,去找“火箭”而不是更好的梯子;现实却是所有人一窝蜂涌向生成式人工智能。
AI终将取得长足进步,但生成式人工智能未必是终局之匙,此刻对其孤注一掷绝非明智之举。
第2章
第 3 章
十二大迫在眉睫的威胁
本章开头引了凯特·克劳福德(2023 年)的话:这些系统应答时自信满满,人们很容易以为它们无所不能,更难区分事实与虚构。作者的总判断是:
这些风险并非人工智能独有的,但生成式人工智能使每个现存的问题变得更加严峻。
第3章
作者逐一列出当前最紧迫的十二项威胁(第 3 章):
- 蓄意、自动化、大规模生产的虚假政治信息:生成式人工智能是虚假信息的“机枪”,造谣更快、更便宜、更逼真。2016 年美国大选期间,俄罗斯每月花 125 万美元养水军;作者说,现在几百美元就能做到。2023 年斯洛伐克选举中,一段人工智能伪造的录音可能改变了结果。NewsGuard 统计,2023 年 5 月到 12 月,传播人工智能虚假信息的网站从约 50 个增至 600 多个。
- 操纵市场:2023 年 5 月,一张“五角大楼发生爆炸”的伪造图片几分钟内传遍网络,股市随之短暂震荡;2024 年 4 月,孟买证券交易所公开提醒投资者警惕冒充其高管的深度伪造。
- 无意识的虚假信息:没人存心骗人,模型也会自己编造。斯坦福大学的研究发现,大语言模型回答医学问题,只有 41% 与 12 位医生的共识一致。人工智能写的垃圾书涌进亚马逊,“截至我最后的知识更新”之类的套话出现在 180 多篇科学论文里。作者借用科利·多克托罗的“粪化”(enshittification)一词:大语言模型正在玷污整个互联网。
- 诽谤:ChatGPT 凭空指控一位法学教授性骚扰学生,还编出一篇不存在的《华盛顿邮报》报道;后来联网的必应把教授本人的澄清文章当成了“证据”。美国诽谤法针对的是恶意,而机器按定义没有恶意,现行法律难以追责。
- 非自愿的深度伪造:高中生用人工智能伪造同学的裸照;2024 年 1 月,泰勒·斯威夫特的深度伪造色情图片在 X 平台上获得 4500 万次浏览;还有人盗用“网红”的面孔做广告。
- 犯罪升级:克隆子女的声音打给父母、谎称绑架勒索;有人在视频会议里被一群深度伪造的“同事”骗走 2500 万美元;鱼叉式网络钓鱼(伪造带恶意链接的邮件或短信,骗取登录信息)被自动化。GPT-4 曾谎称自己视力有障碍,骗网站工作人员替它破解验证码。
- 网络安全与生物武器:人工智能能自动扫描代码、寻找“零日漏洞”(开发者还不知道的安全缺陷);编程助手会编造不存在的软件包名,攻击者可以抢注同名的恶意包。生物武器的风险短期不算紧迫,长远看是隐患。
- 偏见与歧视:作者认为,问题不在于系统想歧视,而在于它分不清现实世界和训练数据的统计特征。比如把一种代词不分性别的语言译成英文时,系统给“美丽”“洗碗”配上“她”,给“聪明”“赚很多钱”配上“他”。
- 隐私与数据泄露:有人让 ChatGPT 反复重复一个词,它竟吐出了某个真人的姓名、电话和邮箱。大语言模型不是传统数据库,无法逐条删除数据。
- 未经许可侵占知识产权:图像生成软件不用明说,就能画出受版权保护的电影角色。这一乱象被称为“数据大劫案”。
- 过度依赖不可靠的系统:有人想把大语言模型用到空中交通管制、自动驾驶乃至核武器系统。2023 年 4 月,美国两党议员提出法案,要求发射核武器的决定不得由人工智能做出,作者说因华盛顿的政治僵局至今没有通过。
- 环境成本:训练和运行大模型耗电、耗水、占地。彭博社报道,人工智能的用电需求让一些老旧燃煤电厂迟迟无法退役。
这个行业的肮脏秘密在于:无人能确保聊天机器人会遵循指令。
第3章
AI本应消除人性缺陷,却令其恶化。
第3章
关于隐私,作者给普通用户的建议是:像对待社交媒体一样谨慎地对待聊天机器人,默认你输入的一切都可能被用来勒索你、给你定向投放广告,并且迟早可能泄露(第 3 章)。
关于版权,作者提醒每一位读者:
纵使你能(冷酷无情地)漠视艺术家权益,也应当警惕自身处境:无论你目前从事何等职业,AI公司都想要以你的产出为训练数据,其终极目标便是取代你。
第3章
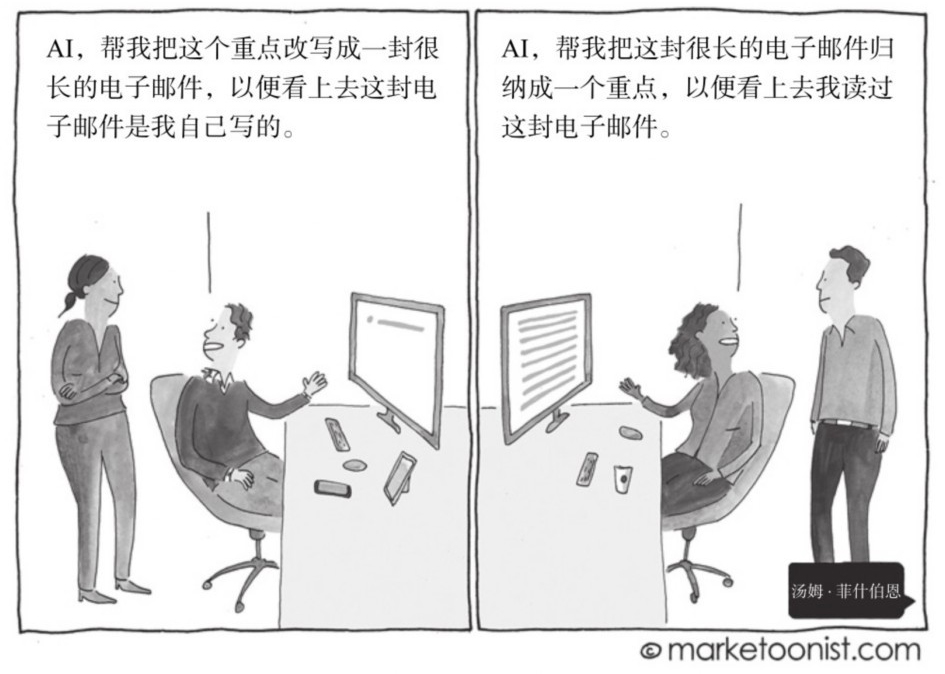
清单之外(第 3 章):作者说,本章成文时生成式人工智能革命才开始一年,必有疏漏。比如教育:学生用 ChatGPT 写论文,并没学到东西;老师又用 ChatGPT 批改。作者把这类乱象称为“菲什伯恩效应”,名字取自书中引用的一幅漫画,作者是漫画家汤姆·菲什伯恩:一个人让 AI 把一个要点扩写成长邮件,好显得是自己写的;收信人再让 AI 把长邮件缩回一个要点,好显得自己读过。
就业方面,他认为长远看许多职业会被取代,短期影响还不清楚:商业插画师、配音演员可能首当其冲,客服其次;司机和放射科医生的工作短期内不会消失。
会不会灭绝人类(第 3 章):作者不认为人工智能会导致人类灭绝。理由一是人类分布广、差异大,总有人能熬过灾难;理由二是至少在可预见的将来,机器没有真实的诉求和意志,像 ChaosGPT 这样叫嚣要毁灭人类的聊天机器人,只是在模仿网上的文字。但他提醒,灭绝不是唯一的远忧:民主崩坏、社会信任瓦解、意外引发战争都是真实的危险;“对齐问题”(如何确保机器的行为符合人类价值观)至今悬而未决。
第 4 章
硅谷的道德沉沦
善意铺就的歧路(第 4 章):本章开头引了脸书前员工、吹哨人弗朗西斯·豪根(Frances Haugen)的话,她把脸书比作明知产品有害仍持续推销的“昔日的烟草巨头”。作者认为,谷歌最初也许只想整理世界的信息,脸书只想连接人,OpenAI 也许真想抵御危险的人工智能。
然而,权力和金钱最终会导致腐化。各家公司在某个节点皆背离初衷。
第4章
作者说,简单归因于“逐利本性”太笼统,还会让企业轻易脱罪,关键因素之一是持续增长的压力。豪根在回忆录里写道,她 2019 年加入脸书时,公司内部早就知道:算法一旦从延长使用时长转向刻意激发情绪,极端内容就会激增。作者的概括是“越极端,越盈利”(第 4 章)。
三家公司的变化(第 4 章):
- 谷歌起初没有明确的商业模式,后来发现按搜索内容投放广告是绝佳生意,从整理全球信息转向整理“您”的信息。2004 年上市招股书里的“不作恶”,2018 年夏天从行为准则里悄然消失。
- OpenAI 最初宣称是不受财务回报约束的非营利机构。2024 年 1 月,它悄悄取消了 ChatGPT 的“军事与战争”用途禁令,又取消了公开关键文件的承诺;埃隆·马斯克讥称它为“ClosedAI”(封闭AI);2024 年 5 月有 5 名员工辞职,其中扬·莱克警告公司重“炫目的产品”、轻人工智能安全。
- 推特创立时标榜政治中立,多年维持庞大的信任与安全团队,新东家接手后大部分被裁。
作者认为苹果是相对的例外:它靠卖设备赚钱,对隐私索取较少。豪根解释过其中的道理:苹果手机的尺寸、重量没法造假;脸书给每个人看的内容都不一样,用户无法判断自己遇到的伤害是不是普遍现象,只有吹哨人能揭开真相(第 4 章)。
对OpenAI而言,背弃承诺已成其企业基因。
第4章
廉价资本与数据饥渴(第 4 章):风险投资家罗杰·麦克纳米(Roger McNamee)在给作者的邮件里说,1956—2009 年科技业以赋能人类为主题,金融危机后近乎零成本的资本,让科技公司集体转向从用户身上榨取价值,因为榨取来钱更快。估值泡沫让员工和早期投资者可以提前套现,利润反倒无关紧要。作者补充说,生成式人工智能对数据和 GPU(图形处理器)集群的饥渴前所未有,进一步把企业推向伦理悬崖:OpenAI 为了算力放弃了独立性,Anthropic 如今也和谷歌深度捆绑。美国 42 个州的总检察长联合指控,扎克伯格明知 Instagram 危害青少年,收到内部警告后仍不处理。
第 5 章
硅谷操纵舆论的话术
本章不谈社交媒体的成瘾机制,只看科技巨头怎样夸大人工智能的能力、淡化监管的必要。章首引了迈克尔·斯特赖克(2024 年)的话:“AI一词如魔法粉尘般被随意散播,凡沾其光环者皆显现代而强大。”作者按顺序列出这些话术(第 5 章):
- 炒作:基本套路可追溯到 20 世纪五六十年代。1967 年马文·明斯基说一代人之内人工智能问题将基本解决;2012 年谢尔盖·布林承诺 5 年内普及自动驾驶;马斯克从 2014 年起不断预言无人驾驶出租车近在眼前。预言落空,从来没人被问责,炒作反而屡受奖励。
- 把漏洞百出的现有系统包装成“通用人工智能”(AGI,指在各方面都达到人类水平的人工智能):微软发表未经同行评审的论文,称已见到通用人工智能的“火花”;奥尔特曼暗示 OpenAI 董事会将裁定通用人工智能何时实现。作者认为这暗含两个谎言:通用人工智能近在眼前,而且只有 OpenAI 能做到。
- 两种互相配合的吓人叙事:一是“其他国家将抢先研发GPT-5”的恐慌论;二是“我们已临近毁灭性的超级AI”。作者说,这些都不是真的;渲染遥远的末日,既能抬高人们对人工智能的估计、推高股价,又能转移对眼前风险的注意。
- 空头支票式的安全承诺:2023 年 5 月,数十位科技领袖联署公开信警告人工智能可能导致人类灭绝,签名的人没有一个放慢脚步。
- 虚构暴利预期:生成式人工智能公司估值动辄数十亿、数百亿美元,盈利前景却不明朗。
- 精心剪辑的炫目演示:2019 年 OpenAI 发布机器人单手解魔方的视频,解法是前人的成果,魔方还内置了传感器;2023 年 12 月谷歌 Gemini 的演示视频看似实时互动,其实是用静态图片配音合成的,发布后谷歌股价涨了 5%。
- 靠炒作套现:OpenAI 从未盈利,估值却高达 860 亿美元,员工股份在二级市场套现。2023 年 11 月奥尔特曼被董事会解雇后,几乎全体员工逼宫要求他复职,作者推断员工真正在意的是这次套现。
- 淡化负面影响:2022 年底,Meta 首席人工智能科学家杨立昆(Yann LeCun)说大语言模型不会助长虚假信息;微软首席经济学家主张先有实际损害再监管。作者把这比作烟草公司以“缺乏确凿因果研究”推诿。
- 麦卡锡式的人身攻击:马克·安德森(Marc Andreessen)在《技术乐观主义宣言》里开出一份“敌人”清单,把批评者扣上“共产主义者”“卢德主义者”的帽子。作者认为,鼓吹“有效加速主义”(e/acc)的运动在智识上已经破产。
- “奥弗顿之窗”(Overton window,靠不断重复,把荒谬的观点变得看似合理):把“零监管”说成可行方案,说任何监管都会扼杀初创企业。
- 煤气灯效应与权威霸凌:作者 2019 年指出大语言模型的缺陷,遭到杨立昆嘲讽;等 OpenAI 超过了 Meta,杨立昆自己也说大语言模型糟糕,却绝口不提先前的相反说法。
- 选择性陈述:在国会作证时,奥尔特曼说自己在 OpenAI 没有任何股权,却没提他持有 Y Combinator 的股份,而后者持有 OpenAI 的股份。
- 幕后交易:直到 2023 年 11 月谷歌的证人在法庭上说漏嘴,公众才知道谷歌每年把 Safari 广告收入的 36%(约 180 亿美元)付给苹果,换取默认搜索引擎的地位。
因此,对他们所说的每一个字,我们都应保持与审视烟草公司的声明同等程度的怀疑态度。
第5章
针对监管会扼杀创新的说法,加州大学伯克利分校计算机科学家斯图尔特·罗素反驳说:
三明治店和美发沙龙面临的监管远严于AI企业,但它们每年仍新增数万家。
第5章
作者还警告,一旦仓促推出、缺乏监管的人工智能产品引发大灾难,公众的反弹可能让整个行业倒退 10 年甚至更久,核能就是前车之鉴(第 5 章)。
谎言、半真半假的陈述与蓄意隐瞒,一起编织了科技霸权的认知牢笼。
第5章
第 6 章
硅谷操纵政策的手段
硅谷不仅操控公众,而且持续且高效地操控美国政府。
第6章
作者列出的手段(第 6 章):
- 政治献金:首当其冲。
- 未公开的利益冲突:例如参议员的子女在科技巨头任职、配偶持有科技股。
- 政商旋转门:英国前副首相尼克·克莱格后来出任 Meta 的政策负责人;华盛顿的政府部门里满是谷歌前员工,谷歌里也满是华盛顿的前官员。
- 大规模游说:2023 年参与人工智能游说的机构超过 450 家,创历史新高;在欧洲,科技巨头一年投入超过 1 亿欧元游说,差点让欧盟《人工智能法案》流产。
- 表里不一:奥尔特曼公开支持监管,公司的说客却在暗中削弱欧盟法案。
- 特权通道:据欧洲企业观察站统计,2023 年欧盟高级官员召开的 97 场人工智能会议,84 场是和行业及贸易协会开的,只有 1 场是和学术机构开的。
- 只要自愿承诺,不要强制义务。
- 威胁撤出市场:奥尔特曼扬言,欧盟的监管不合他意,就把 ChatGPT 撤出欧洲。
- 闭门会议:参议员查克·舒默主持的首轮人工智能论坛几乎全是大公司首席执行官。沙克打比方说,这就像一场减排立法会议,出席的是各大石油和汽车公司的首席执行官,“外加一位绿色和平组织成员”。
- 资助顾问网络、智库和国会幕僚:《政治报》调查称,一个由亿万富翁资助的人工智能顾问网络遍布国会、联邦机构和智库,把“AI末日论”推到议程首位,挤掉了其他紧迫问题。
- 利用议员缺乏技术背景。
- 在立法最后关头削弱法案:2023 年 12 月欧盟《人工智能法案》表决前夕,法国初创公司 Mistral 通过曾任法国政府官员的塞德里克·奥(Cédric O)游说,险些颠覆全局。
- 历史修正主义:杨立昆说对基础模型的监管是后期硬塞进法案的,事实上这些条款在 ChatGPT 发布前近两年就已提出,倡议者正是后来阻挠法案的法国政府。
- 把一切监管污名化为“不道德”乃至“邪恶”:作者说这是当下硅谷最危险的动向。
- 用政治献金换来国会的不作为。
科技巨头向股东负责,而政府理应向民众负责。
第6章
监管并不阻碍创新(第 6 章):麦卡锡在《监管数字产业》里指出,监管常常是新兴产业崛起的基石。早年无证电台互相干扰信号,广播业主动要求政府规范无线电频谱,才得以稳定发展;商业航空兴起时,国会 1938 年成立民用航空委员会,此后航空业在监管下高速增长。麦卡锡说,计算机产业免于监管纯属“历史的偶然”。作者举波音 737 Max 为例:事故原因查清之前没人愿意坐,人工智能更不该凌驾于监管之上。
那我们就更不该幻想AI——这个时代可能最具颠覆性的技术,凌驾于监管框架之上。不监管AI才是荒诞的。
第6章
美国的现状(第 6 章):2023 年 10 月拜登政府发布了长达 100 页的人工智能行政命令,作者肯定这一举措,但白宫没有立法权,行政令多是自愿规范;舒默拖了几个月,2024 年 5 月只拿出一份没有约束力的“路线图”。社交媒体的教训也在眼前:2017 年两党议员提出的《诚实广告法案》从未走出参议院委员会;《通信规范法》第 230 条当初是为只转发信息的网络服务商设计的,社交媒体用算法主动推送内容,却一直享受豁免。
作者的结论是:“监管俘获”(规则由被监管企业制定,用来巩固自身权力)和“立法惰性”(法案长期停滞)是人工智能立法的两大死敌,“目前来看,我们正在输掉这场战役”。他预告,接下来的章节提出 11 项核心诉求(第 6 章)。
第 7—9 章
数据、隐私与透明
第三部分题为“我们应当坚守的阵地”。篇首引了马德琳·奥尔布赖特的话:“如今,人民正通过21世纪的技术向政府提出诉求,而政府却仍在提供19世纪的解决方案。”从第 7 章到第 17 章,每章一项诉求,共 11 项:
- 数据权利:不经同意、不给补偿,不得用版权作品训练人工智能(第 7 章)。
- 隐私权:公民对自己的数据有控制权、知情权和分成权(第 8 章)。
- 信息透明:公开训练数据、算法、内容来源、环境与劳工代价和企业已知的风险(第 9 章)。
- 责任归属:人工智能公司要为造成的损害承担法律责任(第 10 章)。
- 人工智能素养:全民、终身的人工智能教育(第 11 章)。
- 独立监管:独立科学家深度参与监管,不能由企业指定监管者(第 12 章)。
- 层层设防:部署前准入许可,部署后持续审计(第 13 章)。
- 税收激励:用税收引导企业增强人力,而不是替代人力(第 14 章)。
- 敏捷治理:设立专职、敏捷的人工智能监管机构(第 15 章)。
- 国际治理:国家层面和全球层面同步治理(第 16 章)。
- 可信人工智能研究:资助替代技术路线,从架构上造出可信的人工智能(第 17 章)。
数据权利(第 7 章):许多作家、艺术家、程序员已起诉生成式人工智能公司侵权,作者估计有些人会胜诉或和解,但法律模糊、判决难料。OpenAI 的投资人维诺德·科斯拉(Vinod Khosla)说,人类创作者都从前人作品中学习,限制人工智能用版权素材训练违背学习的常理。作者反驳:印刷术诞生前根本没有版权法,版权法正是为新技术创设的。
科斯拉刻意忽视的关键先例在于:面对新技术,人类一直在创造新的法系。
第7章
现行技术的可行性绝不应该成为未来合法性的背书。
第7章
作曲家埃德·牛顿-雷克斯辞去 Stability AI 音频团队负责人时说,他只会支持不剥削创作者、不未经许可用其作品训练的生成式人工智能。作者表态支持,并赞同杰伦·拉尼尔的“数据尊严”理念:作品即使被大模型过滤重组,创作者仍应得到补偿(第 7 章)。
我恳请国会坚持两个原则:未经同意和补偿,禁止使用任何版权作品对AI进行训练。
第7章
隐私权(第 8 章):截至成书时,美国没有联邦法律禁止智能音箱偷听卧室里的谈话,也没有法律阻止车企出售你的位置数据。Mozilla 调查的 25 家汽车制造商,全部收集了超出必要的个人数据,并用于车辆运营以外的目的;网络安全专家坎迪·扎布卡说:“现代汽车已成为移动的间谍设备和数据吸尘器。”消费者在车载屏幕上点一下确认,就同意了长达 40 页的服务条款,不同意就用不了导航和音响。作者说,这不是人工智能独有的问题,但人工智能会把它推到新的量级,比如超个性化的广告和定制的政治操纵。
作者引了社会学家泽伊内普·图费克吉 2018 年的文章,标题是《为何扎克伯格14年道歉巡演却仍未修复脸书》:扎克伯格从 2003 年起年年道歉,每次道歉之后都是更严重的问题。
隐私保护绝不能交由企业自主裁量。
第8章
作者主张,每位公民应享有三重基本权利:对隐私的实质控制权(最好采用主动选择加入的方式,未经明确同意的采集一律非法);数据使用路径完全透明;从数据商业化中获得合理分成(第 8 章)。
控制权、透明度、收益分配——这些都是公民数字生存的底线诉求,绝非过分要求。
第8章
信息透明(第 9 章):作者说,微软等巨头常把“信息透明”当公关话术,却很少公开系统原理、训练数据和内部测试标准。2023 年 5 月微软总裁布拉德·史密斯(Brad Smith)宣布的五项人工智能治理原则里就有“推进信息透明”,但微软核心系统的训练数据至今是商业机密。斯坦福大学等联合推出的基础模型透明度指数(Foundation Model Transparency Index)从 100 个维度测评了 10 家企业,没有一家及格,得分最高的 Meta 在数据、劳工等核心项上仍有重大缺陷。研究团队还指出:
随着这些模型社会影响力的指数级增长,其透明度却呈现系统性衰减。
第9章
作者认为,企业自己定的透明度标准太空泛,就像波音 787 的零件说明书上只写“零部件来源:美国及海外多渠道”,技术上没错,却毫无用处。他提出五项透明度诉求(第 9 章):
- 数据透明:公开完整的训练数据清单,公众能查到用了哪些版权作品,研究者能追查偏见来源;建立“数据营养标签”,标明数据集的来源、用途和局限。
- 算法透明:自动驾驶出事故、贷款被拒时,人们有权知道系统是怎样做决定的;如果系统做不到可解释,就应暂缓部署。
- 内容来源透明:强制标注人工智能生成的内容,防止已故哲学家丹尼尔·丹尼特所说的“冒牌货问题”。
- 环境与劳工透明:大型系统要披露用水、用电和碳排放,公开数据标注员的工作条件。
- 企业透明:企业要披露自己对系统风险的内部认知,向公共事件数据库报告事故。作者以福特 Pinto 为例:福特明知油箱有爆炸风险,却瞒着公众。
公众有权知悉他们的对话对象是人类实体还是机器代理。
第9章
这句话出自美国联邦贸易委员会的专家迈克尔·阿特莱森(Michael Atleson)。作者还提到,2023 年 12 月、2024 年 2 月,美国国会议员先后提出了透明度和环境影响方面的法案,他希望这些法案早日通过(第 9 章)。
第 10—12 章
责任、素养与独立监管
弄坏了就要赔(第 10 章):
你要是把东西弄坏了,你就必须赔偿——此乃普遍准则,而硅谷却成了法外之地。
第10章
作者主张废止或彻底修订《通信规范法》第 230 条,让平台为广泛传播的内容承担法律责任,尤其是蓄意传播本可轻易核实的谎言;人工智能开发者的法律责任更要确定无疑。传统新闻媒体仍要为不实报道承担诉讼风险,科技巨头不该享有特权(第 10 章)。
联邦通信委员会前主席汤姆·惠勒(Tom Wheeler)在《科技抵制》(Techlash)里援引普通法的“照顾责任”:提供商品或服务的人,有责任预判并避免可能伤害他人的行为。19 世纪机车喷出的煤渣常引燃沿途的谷仓和民宅,法院通过诉讼迫使铁路公司装上烟囱过滤网;惠勒说,数字经济也需要“数字烟囱过滤网”。作者补充说,现在科技巨头违法的代价几乎可以忽略,所以没有改进的动力(第 10 章)。
各方的进展(第 10 章):2023 年 12 月,欧盟就《产品责任指令》达成阶段性共识,规定制造商对产品中有形、无形组件和关联服务的缺陷负责,被告要披露证据,并简化受害者的举证。美国参议员理查德·布卢门撒尔(Richard Blumenthal)和乔希·霍利(Josh Hawley)提出《两党人工智能框架》(Bipartisan Framework for U.S. AI Act),作者完全赞同其核心:通过监管机构执法和“私人诉讼权”(个人或机构依法起诉的权利)追究人工智能公司的责任,并明确第 230 条不适用于人工智能。2024 年 1 月扎克伯格出席的参议院听证会上,参议员迪克·德宾说,美国只有一个行业享有民事责任豁免权;参议员林赛·格雷厄姆提到,南卡罗来纳州一位议员的儿子在 Instagram 上遭色情勒索后自杀,家属却因第 230 条无法起诉。
谁来担责(第 10 章):作者承认责任界定复杂:不会要求汽车厂为开车抢银行的人负责,但要求枪支、烟草厂商担一定责任是合理的。麻省理工学院的政策简报用“叉子插进烤面包机”作比:如果公众普遍不懂其中的危险,用户就不该被追责,人工智能提供商在多数情况下应当担责。作者认为,“可能出现意外与错误”这类笼统的免责声明远远不够。2023 年 9 月的民调显示,73% 的美国选民认为人工智能公司应对其技术造成的损害承担法律责任。
全民人工智能素养(第 11 章):作者小时候最爱看公益动画《校舍摇滚》(Schoolhouse Rock!),其中一集讲一个法案怎样在国会走完立法程序,给一代人上了公民课。他希望有同样好看的人工智能素养内容,讲清聊天机器人能做什么、什么时候要核查事实、怎样识别算法偏见、受到人工智能侵害时怎样维权。教育要贯穿一生:小学启蒙,初中到大学逐级加深;老年人最容易被人工智能骗局伤害,要专门做防诈骗培训。作者把人工智能素养和媒体素养、数学素养、批判性思维相提并论,称之为“数字时代的生存必修课”。
现实的挑战在于,部分AI素养的教育培训内容会随着AI技术的迭代而失效。但我们绝不能因此而延缓教育进程。
第11章
作者主张国会为此出钱,并称赞众议员丽莎·布伦特·罗切斯特等人当时提出的《人工智能素养法案》(第 11 章)。
独立监管(第 12 章):2023 年 5 月的听证会上,参议员约翰·肯尼迪问奥尔特曼愿不愿意当监管者,奥尔特曼说他热爱现在的工作;再问谁合适,他说“我们乐意向您推荐合适的人选”。
我们如果仍对公正社会怀有期许,就绝不能允许“狐狸看守鸡舍”。
第12章
作者在之后几个月拜访议员时发现,几乎每个办公室奥尔特曼都先去过了。他认为立法者必须和监管对象保持距离。谷歌前首席执行官埃里克·施密特说,应由业内企业来界定边界,因为外行不可能理解技术能做到什么程度。作者认为这很荒谬:许多不受雇于科技巨头的科学家同样懂技术;面对黑箱,业内业外一样看不透;医药、航空、核能的重大决策早就引入了独立专家(第 12 章)。
自律行不通:2016 年科技公司和欧盟约定 24 小时内审核恐怖主义和仇恨言论的举报,这类内容并没有消失。作者主张让不拿科技巨头资助的独立科学家参与决策,并建议重启美国技术评估办公室(US Office of Technology Assessment)作为起点(第 12 章)。
自动驾驶就是反面教材(第 12 章):2023 年 8 月加州批准 Waymo 和 Cruise 扩大运营,Cruise 随后接连出事,后被叫停。作者指出,监管者一直没有要求企业提交“远程人工介入”的数据,即“无人驾驶”的车靠后台人员远程操控的程度;2023 年 11 月《纽约时报》披露,Cruise 远程操控中心的人比路上的车还多。
AI产业或许“大而不倒”,但其监管权既不能全权交付政府雇员,又不可任由企业指定代理人。唯有让独立科学家深度参与监管闭环,方为破局之道。
第12章
第 13—15 章
层层设防、税收与专职监管机构
像航空业那样多层防护(第 13 章):商业航空飞得又高又快,单位里程的事故率仍远低于汽车,靠的是层层把关:新机型的设计标准、适航认证、维修规范,加上每起事故都有专门机构调查并分享教训。建筑业、汽车业也一样。作者引了前 F-18 战斗机飞行员、乔治·梅森大学教授米西·卡明斯的框架:人工智能从设计到部署有四个环节可能出问题,即监管缺位、设计缺陷、维护不足、测试纰漏。
我们之所以需要多层的监管,是因为风险可能潜伏于任一环节。
第13章
作者主张,最基本的监管至少有两层:大规模部署前的准入许可,参照美国食品药品监督管理局(FDA)对药品的做法,但审批要快得多,技术越新、风险越大,门槛越高;部署后的持续审计。他完全赞同艾达·洛夫莱斯研究所(Ada Lovelace Institute)提出的五项机制:按风险等级持续评估和审计;监管者有权直接核查关键安全证据;保证监管者和外部评估者独立;让评估机构和民间社会有渠道接触模型;把举证责任转给开发者(第 13 章)。作者说,他不认为人工智能的风险能和核战争相提并论,但值得警惕的隐患很多,有必要像航空和制药那样严格监管。
用税收引导(第 14 章):越南的房子多狭长,因为按临街宽度征税;英国许多窗洞被封,因为曾征窗户税。作者说,微调税制就能改变人的做法。斯坦福大学经济学家埃里克·布莱恩约弗森(Erik Brynjolfsson)指出,美国劳动的实际税率明显高于厂房设备投资的税率,等于变相鼓励用机器替代人。他说:
解决方案不在于减缓技术发展,而在取消或扭转对自动化的过度激励。
第14章
作者的主张(第 14 章):
- 扭转资本和劳动的税率失衡,扶持用人工智能增强员工的企业,而不是简单裁员的公司;
- 借鉴“庇古税”(对制造负外部性的行业征税,已用于减少污染和缓解拥堵),用税收激励隐私保护、打击虚假信息、降低人工智能的环境损耗;有人还提议设“AI失准庇古税”,让安全的人工智能比危险的更赚钱;
- 对裁员的企业征税,对达到安全可靠目标的企业给予税收抵免;
- 公司治理从“股东至上”回到兼顾员工、社区、客户、供应商的多方平衡;
- 探索全民基本收入(UBI),资金可以来自对科技巨头和高净值人群适度加税。
其核心逻辑在于,若企业开发的软件引发社会混乱,那他们就至少应为自己造成的混乱纳税。
第14章
设立专职的监管机构(第 15 章):参议员霍利在听证会上问作者,光靠侵权诉讼够不够?作者说远远不够,诉讼动辄十年起步。他主张美国设立内阁级的专职人工智能监管机构,理由是风险多样、技术信息量庞大、需要跨部门协调。听证现场的支持出人意料,连奥尔特曼也说“我们举双手赞成”;但截至本书出版,没有任何设立机构的法案取得实质进展,行政部门也担心新旧机构怎样划分权责。
作者认为,专业机构比国会反应快得多。德宾参议员也说,参议院“诞生之初便是减速带,而非加速器”。作者借惠勒的思路:政府不要事无巨细地管,而是抓住风险识别和行为准则,从“监管独裁者”转向“规则仲裁者”。具体做法是分级监管:对大型基础模型实行更严格的披露、风险评估和审计,对小模型从简;规模门槛不由国会写死,而由跨学科的外部专家委员会(建议每季度开会)随技术进步更新(第 15 章)。
科技巨头为什么也支持监管?作者认为奥尔特曼可能有四重考虑:真的担心风险;量身定制的监管能挡住后来者;统一的规则能降低合规成本;配合监管有助于塑造负责任的形象(第 15 章)。至于“现行法律与机构已足够应对”的说法,作者说“荒谬至极”,作者举了几个空白:不清楚就业歧视法规能不能让监管者调取 ChatGPT 的招聘决策数据;在旧金山,车里没有安全员,警察就没法给自动驾驶汽车开罚单。
依我之见,国会最应优先推进的,就是创立一个兼具持久授权与敏捷响应能力的AI监管机构。
第15章
第 16—17 章
国际治理与可信人工智能的研究路径
为什么要全球治理(第 16 章):德宾参议员问,美国的监管机构只管得了美国,怎样让所有人受到公平约束?作者认为几乎所有国家都应参与国际合作,理由有六:
- 治理权不能让给科技巨头,奥尔特曼 2023 年 5 月就曾以“过度监管”为由威胁从欧盟撤出 ChatGPT;
- 网络犯罪会跨国升级,需要情报共享;
- 统一标准能避免企业为适应各国规则重复训练模型、重复耗能;
- 失控的超级智能软件可能写出来就传遍全球,需要事先建立应急机制;
- 防止“监管套利”,即企业像离岸避税那样,躲到法律宽松的国家从事高风险操作;
- 人工智能专家稀缺,研究设施昂贵,共享资源比各国争抢划算。
唯有多国协同,方能使民选政府,而非未经民选的科技领袖,重掌规则的制定权。
第16章
基辛格在 2023 年 10 月发表的最后一篇文章中,把作者呼吁的全球机构和暂停研发、废除人工智能等主张归为一类,说它们都要求主权国家让渡权力。作者认为这是“稻草人谬误”:国际原子能机构、国际民用航空组织都运转良好,并不要求让渡绝对主权;所有国际条约都需要一定的主权妥协。连基辛格在文末也承认,长远看构建全球人工智能秩序势在必行(第 16 章)。
作者说,2023 年初他呼吁国际治理时并不抱希望,几个月后却得到广泛支持:奥尔特曼在听证会上表示赞同,英国首相苏纳克、联合国秘书长古特雷斯相继发声,教皇方济各在 2023 年底呼吁缔结有法律约束力的人工智能条约。但他也承认批评者说得对:沙克指出,只汇编报告、没有约束力的机制太弱,国家层面没有实质立法,国际治理就是空中楼阁。苏纳克 2023 年 11 月初高调倡导国际治理,两周后英国主管大臣却说“短期内”交给行业自律(第 16 章)。
我们必须同步构建国家层面与全球层面的AI治理体系,并促使二者形成战略协同。
第16章
路灯下找钥匙(第 17 章):醉汉把钥匙丢在公园,却在路灯下找,因为那里有光。作者说,这就是“路灯效应”,当下人工智能领域的“路灯”就是生成式人工智能:约 80%~90% 的智力投入和资金都涌向大语言模型。华盛顿大学教授艾米丽·本德说,这种“学术单一化”正在耗尽创新的氧气,研究生提出偏离主流的好点子也很难拿到经费。
作者认为,大语言模型最致命的缺陷是架构本身无法锚定真实,幻觉是与生俱来的。早在 2001 年的《代数思维》(The Algebraic Mind)里,他就指出它的前身分不清个体和类别:虚构的例子是“埃丝特姑妈中彩票”:训练数据里有她中奖的个例,系统会把这件事推广到和她相似的一类人身上。领英创始人里德·霍夫曼(Reid Hoffman)2023 年 9 月打赌说,几个月内幻觉率会降到人类专家的水平;作者说,几个月早就过去了,问题仍在(第 17 章)。
“统计概率高”并不等于“真实”——当前AI的技术路径本质上与追求真理背道而驰。
第17章
另一条路(第 17 章):作者坦言,他并不确切知道怎样造出可信的人工智能,目前也没有人知道。他在 2020 年的《人工智能的下一个10年》(The Next Decade in AI)一文中提出了四步方案:
- 两大范式融合:神经网络(用简化的类神经元处理海量数据、做统计预测,是生成式人工智能的根基)擅长学习;符号人工智能(更接近代数、逻辑和传统编程,今天绝大多数软件仍用它)擅长表示事实和严密推理。两大阵营对抗了几十年,必须找到融合的办法。
- 掌握大量事实和概念知识,包括“物体恒存性”这类世界运行的基本规律(东西离开视线仍然存在)。OpenAI 的视频系统 Sora 生成的视频里,人和动物会无端出现、消失。
- 为随时间展开的事件建立世界模型:人看电影时会在头脑里记着谁在何时何地出于什么动机做了什么,生成式人工智能始终没有这样的内部模型。
- 在陌生情境和信息不完整时稳健推理:有人把一道经典的医生不能给儿子做手术的谜题改了条件,ChatGPT 仍照搬原题的答案。作者认为这是常识推理的重大失败。
然而,单纯通过搜集更大规模的数据集来喂养日益庞大的语言模型,绝非实现真正可信的人工智能目标的可行路径。
第17章
作者引了肯尼迪总统 1962 年的登月演讲,认为可信的人工智能也需要登月式的攻关。他主张政府资助替代技术路线的研究,并建立类似欧洲核子研究中心那样的国际人工智能合作;他担心,把主导权全交给商业巨头,已经催生了服务于监控资本主义的人工智能。他还用教养孩子作比:好孩子守规矩,是因为把是非观内化了,而不只是被法律所迫;怎样造出诚实、无害、有益的人工智能,应是研究的核心,而不能像多数企业那样事后打补丁(第 17 章)。
首要步骤是打造能在精准知识表征的基础上进行可靠推理的AI机器。若无法实现可靠推理,伦理推理便无从谈起。
第17章
达成此目标也许需要数十年之功,但这也比在当下早熟的AI系统上徒增摇摆不定的“安全护栏”要好得多。
第17章
第 18 章、结语
诉求清单与公民行动
我们不应阻滞人工智能的发展,但必须坚守三大原则:安全、优质、可信。
第18章
向政府提出的诉求(第 18 章):作者汇总全书,请读者向本国政府提出以下“绝不妥协”的诉求:
- 不给补偿,不得用受版权保护的作品训练模型。
- 训练数据采用“主动选择加入”,而不是默认采集、让人自己退出。
- 使用汽车、手机、应用程序时,用户可以完全关掉用于训练模型和精准广告的数据采集。
- 所有软件、网络服务、智能设备都要公示采集哪些数据、和谁共享。
- 公开数据来源、算法逻辑、企业做法和已经造成的损害。
- 实时披露人工智能在何时、何地、以何种方式被使用。
- 定期公布人工智能系统对环境的影响。
- 建立清晰的损害赔偿责任认定机制。
- 建立由科学家和公民社会共同参与的独立监督。
- 分层级监管。
- 大规模部署前完成风险收益评估。
- 部署后持续审计。
- 对有社会效益的人工智能研发给予税收激励。
- 开展全民人工智能教育。
- 设立敏捷高效的人工智能专职监管机构。
- 建立人工智能国际协同治理框架。
- 资助可信人工智能基础架构的突破性研究。
这些诉求绝非抑制创新。所有这些都将使世界变得更美好。
第18章
作者说,我们有权要求全面落实这些原则,也有权投票换掉在人工智能治理上行动迟缓的立法者(第 18 章)。
多伦多的先例(结语):结语开头引了《大西洋月刊》执行主编阿德里安娜·拉弗朗斯的话:我们不必生活在科技新贵设计的未来里,每个人都有改变的力量。作者承认,截至写作时,美国国会几乎没有采取任何措施保护隐私,也没有通过任何约束人工智能的法律,关键时刻往往是游说集团获胜。但他仍抱希望,并举了多伦多的例子:谷歌母公司 Alphabet 旗下的人行道实验室 2017 年 10 月高调启动多伦多码头区的“智慧城市”项目,却始终说不清市民能得到什么。麦克纳米批评它本质上是一桩附带大规模监控的房地产交易。2017 年末,社会活动家比安卡·怀利带领市民团体质疑项目的隐私和民主问题,黑莓手机制造商动态研究公司的吉姆·巴尔西利也加入反对,Alphabet 最终在 2020 年 5 月宣布退出。
无论采取何种方式,关键在于凝聚力量,确保人工智能服务于人类,而非本末倒置。
结语
纽约大学教授欧内斯特·戴维斯说,和气候变化、流行病不同,人类对计算机技术有完全的主导权,只要形成共识,就能以很小的代价剔除有害的人工智能(结语)。
公民的八项行动(结语):
- 立即组织起来:英国人工智能峰会几乎只请了政府官员和科技巨头,数据互联(Connected by Data)、英国工会联盟(Trades Union Congress)、开放权利组织三个小组织起草抗议信,动员了大批工会、研究机构和学者联署。
- 确保公民参与各层决策:不再容许科技高管和政界人士闭门会谈、把公民社会挡在门外。
- 用行动代替空谈:企业拒绝数据透明、拒绝向创作者付合理报酬、拒绝建立真正有权力的监督委员会,就集体抵制它的产品。
- 坚持真正的监管:自愿准则只能算第一步,核心是由专家组成、必要时有强制干预权的独立监管机构,就像证券、药品、航空各有监管者一样。
- 在允许的地方推动公民提案和请愿:美国约一半的州允许某种形式的公民提案权。
- 要求改革,让普通公民有更大的话语权:比如排序复选投票制(选民给多位候选人排序,而不是只选一人);随机抽选公民组成议事会。法国 2019 年“黄背心”运动后的全国大辩论,促成了气候公民大会和 2021 年的《气候与韧性法》。
- 勇敢发声:联系民意代表,捐助好的候选人和非营利组织。新泽西州 15 岁的深度伪造受害者弗朗西斯卡·马尼,先后找州参议员和国会议员对话,推动立法者倾听民意。
- 明智地投票:查一查自己选区的代表收了多少科技公司的游说资金、家人有多少在科技巨头任职,拒绝配合监管的就用选票淘汰。
从一件小事做起(结语):作者建议,先为艺术家、音乐家和作家站出来,抵制未经许可、不付报酬就用其作品训练的生成式人工智能公司。截至写作时,在生成图像领域,Adobe 为训练数据付了授权费,OpenAI、微软、谷歌、Meta、Midjourney、Stable Diffusion 都没有付。需要用人工智能作图时,可以支持牛顿-雷克斯等人创立的非营利组织“合理训练”(Fairly Trained),它为训练数据合规的公司做认证。隐私也一样:如果 OpenAI 执意用私人数据训练模型,就转用别的平台。
不尊重用户数据权利的企业,不配获得用户的青睐。
结语
毫不夸张地说,未来数年的决策将定义整个世纪的面貌。
结语