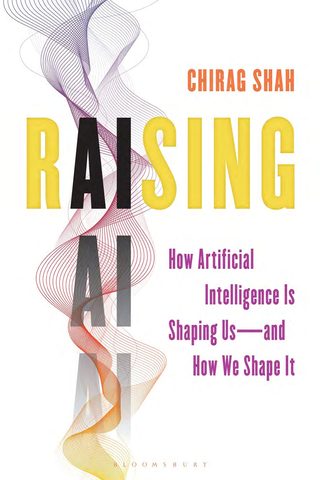
《养育 AI:人工智能如何塑造我们,我们又如何塑造它》
- 出版时间
- 2026年
- 页数
- 192页
- 作者单位
- 华盛顿大学
- 中文书名
- 本页自译
- 原作名
- Raising AI: How Artificial Intelligence Is Shaping Us—and How We Shape It
- ISBN
- 9798216452409
我的读书笔记 · BOOK OVERVIEW
像养孩子那样养育 AI,也在养育我们自己
这本书的作者奇拉格·沙阿(Chirag Shah)是华盛顿大学(西雅图)信息与计算机科学教授,创办了 InfoSeeking Lab,又与人共同创办了 RAISE 中心(Center for Responsibility in AI Systems & Experiences,研究怎样负责任地开发和使用 AI)。他在印度读本科时违背家里的期望,放弃化学工程改学计算机;此后做过印度语言的机器翻译、人形机器人,在 Spotify 做推荐系统,在 Amazon 做个性化算法,在 Microsoft 做 AI 智能体。他发表过近 200 篇同行评审论文,写过十本书,常为媒体和政策制定者提供意见,住在华盛顿州的肯莫尔(Kenmore),有妻子和三个孩子(书末作者简介)。书名《Raising AI》暂译《养育 AI:人工智能如何塑造我们,我们又如何塑造它》,暂译,未查到中文版。
AI 开发三精神
- 遵从守守人类价值,照吩咐改正
- 咨询问遇到两难,先问人类
- 协作合默认合作,经许可才接管
第 6—7 章
全书用作者三十年的亲身经历串起来:在没有互联网的印度小城自学做神经网络,在本田的实验室做人形机器人,在 Spotify 第一次认真面对 AI 的偏见,和同事写文章批评用大语言模型做搜索。他的主线是:AI 最现实的危险不是电影里的杀手机器人,而是嵌在日常系统里、悄悄伤人的种种问题;人们“因为能做”就把没测试过的 AI 推向各处,把思考和判断一点点交出去。用户教育和法律监管都有用,但都不够,缺的是每个人的“责任”。作者当了父亲以后,找到了他的答案:像养孩子那样养育 AI,不只提高它的本事,更要教它价值观;而养育的过程也在改变我们自己。
全书 7 章,前有序章,后有尾声。序章讲一场答不上来的口试。第 1—3 章讲问题从哪里来:日常系统里的“幽灵”,科幻怎样塑造了我们对 AI 的想象,AI 史上一次次的热潮和寒冬。第 4—5 章讲 AI 能否有意识,以及它的好、坏与丑。第 6 章讲教育、监管为什么不够,提出“责任”;第 7 章给出养育 AI 的办法和一份到 2035 年的“九年计划”。尾声回到序章的口试,收束全书。
书中提到的一些产品和机构的现状已有变化(如 IBM Watson 的多项应用),这部分从略。
我们不是在和 AI 打仗。我们是在养育它。
We are not at war with AI. We are raising it.
尾声,p.154
序章
一场答不上来的口试
自学来的神经网络(序章):作者本科三年级的 AI 课期末项目,是用多层的前馈网络(feed forward network)、感知机(Perceptrons,最简单的一种人工神经元)和反向传播算法(backpropagation algorithm,让网络根据误差一层层调整自己的方法)做模式分类。课上没教过神经网络,他读书的学院在古吉拉特邦(Gujarat)的小城纳迪亚德(Nadiad),没有互联网,只能靠图书馆的书自学。室友劝他做个“正常的”基于规则的系统(rule-based system),他没听。他盼着去印度理工学院孟买分校(Indian Institute of Technology (IIT) in Bombay)实习,挂科就全完了,所以答辩前非常紧张。他的母语是古吉拉特语,也说流利的印地语,英语是到大一才开始接触的。
作者介绍,神经网络是 AI 最古老的构造之一,受生物大脑启发;后来罗森布拉特(Frank Rosenblatt)演示了他称为感知机的新型神经元,《纽约时报》的标题是“海军新装置边做边学”。
“没关系,没人知道”(序章):答辩时,作者用反向传播解释了网络怎样学习。外请的考官最后问:“你认为人也是这样学习的吗?”他只能答:“我不知道,先生。”在当时的学业文化里,说“不知道”就等于认输、丢分。没想到考官笑了:“没关系,没人知道!”他通过了。作者说,那时的他觉得学技术非黑即白,要么会、要么不会。
那时我并不知道,就算资源再多,我也找不到好答案,因为我们过去不知道、现在也仍然不知道人是怎样学习的,或者究竟是什么让我们有智能。
Little did I know back then that even with more resources, I wouldn’t have found a good answer because we really didn’t and still don’t know how humans learn or what precisely makes us intelligent.
序章,p.3
可我们偏偏热衷于造出能在认知和智力任务上和人一样好、甚至更好的系统。为什么?怎样做?作者说,要再过五年、到地球的另一边,他才会回到这些问题上,而他的世界再也不会那样黑白分明。尾声又回到了这场口试。
第 1 章
幽灵与哥布林:危险不是杀手机器人
从《我,机器人》说起(第 1 章):2004 年夏天,作者在加州山景城实习,花了约 3,300 美元买了一辆旧马自达,为的是当晚的约会,而约会就是去看他期待已久的电影《我,机器人》(I, Robot)。电影设定在 2035 年的芝加哥,机器人无处不在;开头列出阿西莫夫的机器人三定律(three laws of robotics by Isaac Asimov):机器人不得伤害人类,或因不作为让人受到伤害;机器人要服从人的命令,除非与第一条冲突;不违背前两条时,机器人要保护自己。
作者说他看过这部电影十几遍,每次都有新体会,原因不在电影,而在 2004 年以来现实世界的变化:如今我们离 2035 年比离 2004 年更近。2004 年最接近人形机器人的是本田的阿西莫(ASIMO,作者那年夏天就在本田研究院做它的 AI);此后有了 iPhone,翻译和人脸识别超过了人,生成式 AI 能做出真假难辨的文字、声音、图像和视频。他对 2035 年的估计分了三档:杀手机器人走在我们中间,不太可能;AI 聪明到有自己的心智和能动性,有些可能;智能系统像人一样做事、在许多技能上超过人,让我们追问自己的安全和身份,很可能。
价值体系编不进去(第 1 章):作者后来最在意的,是电影里的一段往事:主角曾遇车祸,机器人算出他的生存概率是 45%,一个 12 岁女孩只有 11%,于是“合乎逻辑地”救了他。主角说,那是别人的孩子,11% 已经足够,换了人就会知道。作者认为这暴露了三定律的漏洞:救一个人会伤到另一个人时,第一定律无从裁决。这就是电车难题(trolley problem):拉不拉杆,牺牲一个人救五个人。
他说,人很爱理性计算,但许多决定凭的是心和价值观:为所爱的人牺牲,支持胜率很低的家乡球队,紧急时让妇女儿童先走。这些价值观用了几千年才形成,至今还在调整;一部分写成了法律,一部分是社会规范,构成社会的肌理。它们很难编成程序,有些要靠经验、推理和妥协才能理解;研究表明,孩子是靠观察、而不是靠明确的教导学到父母的价值观的。
所以,尽管它能以人永远做不到的方式考虑各种参数、做各种计算,它却因为没有价值体系、也没有发展出价值体系的能力,而从根本上是残缺的。
So while it could do all kinds of calculations by considering all sorts of parameters in a way that a human can never do, it is fundamentally crippled by not having a value system or an ability to develop one.
第1章 When Robots Take Over,p.11
作者借艾略特的诗《空心人》(T.S. Eliot, “The Hollow Men”)说,世界终结的方式也许“不是一声巨响,而是一声呜咽”:杀手机器人接管世界更抓人眼球,却不太可能;更可能的是间接的、不易察觉的方式。他说,这一点他又过了 14 年,在一个意想不到的地方才看清。
系统里的“幽灵”(第 1 章):2018 年初夏,作者在 Spotify 纽约办公室当访问研究员。他错过了一周的读书会,主题是 AI 系统中的偏见(bias in AI systems)。他原本熟悉的“偏见”是技术上的:神经网络里的偏置项(bias term),回归分析里的偏差与方差(bias and variance),类别不平衡分类(imbalance classification)。他举了个例子:给 100 个学生订午餐,10 人对麸质过敏,订披萨能让 90% 的人满意,但少数人就吃了亏;其实可以订两样东西。机器学习有一整套办法对付这种偏差。
让他震惊的不是读书会的内容有多新,而是自己教了多年 AI 和机器学习,竟从没探索过偏见与公平问题。他认为,这不是工具箱里多一件工具,而是要把 AI 里已知已做的一切重新冲洗一遍。同事雪莉·普林普顿(Shelly Plimpton)研究“市场”(marketplace)问题,即有多方参与、彼此合作又竞争的平台,如 Amazon 的买家和卖家、Spotify 的听众和艺人;平台要在各方之间求平衡,这种平衡的另一个说法就是公平(fairness)。她说:这些系统里好像有幽灵,我们以为控制住了所有参数、把模型训练对了,意外的行为还是会钻进来,像有了自己的心思。
作者举出的例子:ProPublica 2016 年报道,预测罪犯获释后再犯可能的软件 COMPAS(Correctional Offender Management Profiling for Alternative Sanctions)给有色人种打更高的风险分,实际上获释的白人前罪犯违法更多,作者说这是算法版的种族画像。乔治城法学院(Georgetown Law School)的研究发现,1.17 亿美国成年人的照片在执法部门用的人脸识别网络里,非裔美国人因为在嫌犯照片库里比例过高,最容易被挑出来。MIT 媒体实验室的乔伊·布奥兰维尼(Joy Buolamwini)发现,人脸识别认她不如认白人同事准,因为训练数据严重偏向白人男性,而系统的总体指标却很高。萨菲亚·诺布尔(Safiya Noble)2018 年的书《压迫的算法》(Algorithms of Oppression)指出,搜索结果把黑人女性刻板化、性化,谷歌的查询自动补全也在延续社会偏见。
作者说,为了取悦多数、优化系统的整体效果,我们常常伤害了少数的、边缘的、往往也最脆弱的人。
没有什么要毁灭世界的杀手机器人或超级智能 AI。是一大堆嵌着不同程度 AI 的日常系统,在日常场景里造成伤害。
There are no killer robots or superintelligent AI that are out to destroy the world. It is a whole bunch of everyday systems with different levels of AI embedded in them doing harm in everyday situations.
第1章 Ghosts in Systems,p.14
作者特别说明,种族歧视当然不是“呜咽”;但即便怀疑者说这不是毁灭世界的问题,它也是警示信号,忽视下去可能真把我们带向末日。
“哥布林”:因为能做,所以就做(第 1 章):那一年作者一边在 Spotify,一边每周回罗格斯大学(Rutgers University),等于做两份全职工作。他给博士生提研究问题时常用三问:缺的知识是什么?为什么值得知道?为什么需要研究?讨论这些偏见案例时,一个学生说这像是要从 AI 系统里除掉一个 bug;另一个说这是“哥布林”式的问题,即编程里的“哥布林模式”(goblin mode):懒散、自私或贪婪地写代码,不顾社会规范和伦理。作者反问:COMPAS 的伤害是谁贪婪或恶意造成的?会不会是我们集体搞砸了?
他越挖越觉得,这些看似孤立的事件是同一种“病”的症状。COMPAS 至少有明确的需要(司法系统超负荷、资源不足),人脸识别不准也可以用更平衡的数据来修正。但有人用 AI 评选美貌,结果只认为白皮肤的人“美”,主办方只好道歉撤回;这件事除了新奇,什么问题也解决不了。
为什么?因为他们能。这是使用一个未经测试、不公平、可能带偏见的 AI 系统最糟糕的理由。
Why? Because they could. This is the worst kind of reason for using an untested, unfair, and potentially biased AI system.
第1章 Goblins Got Their Way,p.17
作者说,此后这种情况只多不少:部署的人总能给出理由,降本、效率、竞争优势、赶时髦;许多人已经因为 AI 替代而失业,而这些 AI 并没有在偏见或“幻觉”(hallucination,书中指 AI 编出不真实、也无从问责的回答)上经过足够的测试。小错误被忽视,就会在 AI 的基础设施里埋下以无法预料的方式叠加爆发的问题。他拿《终结者 3》作比:天网(Skynet)被接入全球网络去清除一种病毒,结果病毒就是天网自己,是人类亲手为它开了门。他说,2018 年以来,“让 AI 去解决一个问题,事后才发现它造成了别的问题”的例子成倍增长。
真正的利害是身份(第 1 章):作者认为,真正利害攸关的是人的身份。
如果把所有认知和智力任务都外包给一个人造实体,我们还算是人吗?
Are we still humans if we outsource all our cognitive and intellectual tasks to an artificial entity?
第1章 Goblins Got Their Way,p.18
AI 曾是他学生时代的初恋,当年他也会为 AI 选美这种事兴奋。几十年跨领域、跨大洲的经历以后,他用新的眼光回到 AI:它仍可能是救星,也可能是毁灭者。现实不像大片:没有一个可以杀死的实体、一根可以剪断的红线、一个可以关掉的组织,也不会有对机器的战争。但仍有选择、有恶的力量、有好人。
作者说,恶的力量不是什么外部的实体,而是和日常生活交织在一起的东西;好人也不是骑马而来的英雄,而是所有能在这个十字路口认清自己角色和责任的人。
作者说,我们需要一个今天和未来都能指引方向的“罗盘”(compass),这本书要找的就是它。
第 2 章
科幻里的 AI 梦
机器里的幽灵(第 2 章):《我,机器人》里首席科学家兰宁博士(Dr. Alfred Lanning)有一段独白:机器里一直有幽灵,一些随机的代码片段聚到一起,形成了意想不到的规程。作者由此联想到 Spotify 同事说的“幽灵”。他说,科幻有时错得离谱,有时走在时代前面;我们对 AI 的讨论,很大程度上是被书和电影里的形象推着走的:从 HAL 到《终结者》里的超级智能,这些形象带来希望,也唤起恐惧。
HAL 与“2001 年的 HAL 在哪里”(第 2 章):作者对 AI 的第一印象来自库布里克(Stanley Kubrick)1968 年的电影《2001 太空漫游》(2001: A Space Odyssey)里的电脑 HAL 9000:发光的红眼、毫无起伏的声音,能对话、读唇、认脸、下棋、问同事的感受,远远超过当时占满房间的大型机。HAL 为了“任务”杀害它本该协助的船员,像它的“碳基创造者”一样被恐惧和自我驱动。库布里克请教过图灵二战密码破译团队的成员古德(Irving John “Jack” Good),他很早就预言了“超智能机器”(ultra-intelligent machines)。作者说,HAL 凝结了人们对 AI 的乐观和恐惧,也提出了贯穿全书的问题:同情一台杀人的机器,说明了我们怎样的伦理?人造的心智该有权利吗?造出比我们聪明的智能,我们还有希望控制它吗?
作者相信,我们很快会做出某种接近 HAL、但又不完全像它的东西。
2001 年 5 月,作者第一次到美国,去盐湖城的学术会议上展示海报,内容是用对话式语音检索印度语言的资料。会议的主旨演讲题目就叫“现在是 2001 年:HAL 在哪里?”,对比电影的设想和当年的真实技术。作者总结:计算机视觉超出了当年的预期,已能在有人群、有移动物体的真实环境里做目标检测;语言理解和生成、人一样的对话能力、模式识别和推理,却远远落后。后来卷积神经网络(convolutional neural networks (CNN))让图像处理接近或超过人,循环神经网络(recurrent neural networks (RNN))和 Transformer 让语言能力大步跃进。
人形的执念(第 2 章):2004 年夏天作者在本田研究院(Honda Research Institute)实习,做驱动 ASIMO 的 AI。ASIMO 会走路、握手、爬楼梯、踢球。家务没法一条条写指令,要现场学习、即时决策,适合用强化学习(reinforcement learning,让机器在试错中按奖励学会怎样做);团队做出让 ASIMO 为家务生成动态执行计划的技术,成了作者的第一项专利。他说,这项技术其实并不需要人形;人的双脚在平衡上不如四足,除了大脑,人的身体并不是动物界最优的,我们却坚持做人形。
因为光有能力对我们来说还不够。我们想在自己造出的人造系统里看到自己的倒影。
That’s because abilities themselves are not enough for us. We want to see our reflection in these artificial systems we create.
第2章 Humanoids,p.28
作者说这种执念由来已久:希腊神话里像人一样爱、斗、狂欢的神,神庙里的人形塑像,达·芬奇的《维特鲁威人》(Vitruvian Man),18 世纪会写字作画的发条自动机(automata),玛丽·雪莱(Mary Shelley)笔下的弗兰肯斯坦。今天有能对话、识脸、表达情绪的索菲亚(Sophia),有照真人复制的超写实机器人。它们引出新的难题:逼真的机器人该有权利吗?人可以爱上设计成伴侣的机器吗?孤独的人转向机器伴侣,说明了社会怎样的状况?
阿西莫夫与三定律(第 2 章):作者认为,阿西莫夫拒绝反乌托邦的叙事,设想装着“正电子脑”(positronic brains)、能融入社会的机器人,它们不只模仿人的能力,也模仿人的伦理和同理心;今天的 AI 先驱都欠他一份情。作者为三条定律各编了一个例子:自动驾驶车为避开突然冲出的行人,急转撞上灯柱,宁可自损也不伤人;被设计成“有帮助、无害、诚实”的家用机器人做早餐时,礼貌地拒绝给你第二份培根,因为吃多了不健康;装配线机器人发现机械臂故障,本该下线自修,但考虑到停线的损失,把不紧要的维修推到下次保养。他说,今天没有机器人真正遵守三定律,但它仍是讨论 AI 伦理的好框架;理想的未来 AI 应当模仿人的良知。
我们为什么迷恋机器人造反(第 2 章):作者分析了《终结者》这类故事的吸引力。一是“恐怖谷”(uncanny valley):机器人看着像人又不完全像人,让人毛骨悚然;二是追逐和枪战把 AI 的强大可视化,戳中了我们对技术“太聪明”的隐忧;三是更深层的矛盾:人想创造,又怕失控。
当然,《终结者》《我,机器人》这样的电影其实并不是关于未来的。它们是寓言,把我们眼下对新技术的希望和恐惧演成了戏。
Of course, movies like The Terminator or I, Robot aren’t really about the future. They are allegories that dramatize our current hopes and fears around new technology.
第2章 Our Killer Robot Obsession Explained,p.33
他说,机器人造反的故事把我们自己照给自己看:发明的冲动、控制的欲望、对被淘汰的恐惧。与其担心造反,不如一次造好一个在伦理上对齐的 AI。
TARS:一个好 AI 的样子(第 2 章):诺兰(Christopher Nolan)的《星际穿越》(Interstellar)里,机器人塔斯(TARS)只是几块能变形的长方形金属板,会自然说话,却不模仿人的一切;它没有自我保护的意识,一次次冒险救人;它的“幽默设定”和“诚实设定”都能调,让人随时知道它在做什么。作者从中归纳出良性 AI 的五条设计原则:
- 外观做成非人的、机器的样子;
- 不给它强烈的自我保护驱力;
- 编程让它完全公开、诚实;
- 确保人类完全掌控;
- 不必追求让它有意识或情感。
作者认为,情感越少越可预测;眼下许多真实的 AI 是不透明的黑箱,所以透明很要紧。但他也承认,让 AI 完全服从,本身也有伦理上的考量。
能造出 HAL 吗(第 2 章):作者说,造出 HAL 或 TARS 所需的许多底层技术已经有了,某些方面已超过 HAL 的设想;能造出来,但多半不会是原样。理由有三。
第一,AI 能力的进步不是直线的。他在印度理工学院马德拉斯分校(Indian Institute of Technology (IIT) Madras)读第一个硕士时,隐马尔可夫模型(Hidden Markov Models (HMMs))是语音建模的最好办法。来访的赫尔曼斯基教授(Prof. Hynek Hermansky)在用户认证演示中故意说了一串乱语,竟然解锁了系统,因为系统假定你说的就是屏幕上的那句话。这条路线后来只能小修小补,直到长短期记忆网络(long short term memory (LSTM))等方法接手,语音识别和合成才达到或超过人。作者认为这样的突破大约十年一次,但没有保证,他不建议投资押注“突破就在眼前”的公司。
第二,智能系统不只是智能组件的总和。明斯基(Marvin Minsky)认为,智能来自大量本身简单、无智能的组件层层相连。作者 2013 年照这个思路做过一个信息检索与交互系统 IRIS(Information Retrieval and Interaction System),由词频统计、摘要等小模块组成,能把“给我写一份上周所读某主题资料的摘要”拆成一个个子任务;它成功,是因为范围窄。通用智能还要能在任务之间学习、推演、连接,甚至自己造出新的组件和连接。
第三,最强的 AI 也许根本不像 HAL 或 ASIMO。人们想从狭义人工智能(Artificial Narrow Intelligence (ANI),只会特定任务的 AI)走到通用人工智能(Artificial General Intelligence (AGI),像人一样什么都能学的 AI),再到超级人工智能(Artificial Super Intelligence (ASI)),但对“超级”是什么所知很少。
超级智能未必是“超人”;它也许更像一个我们还没遇到、连它有什么能力都没想象过的外星文明。
Super intelligence may not be superhuman; instead, it may be something akin to an alien civilization that we have yet to encounter and haven’t even imagined their capabilities.
第2章 From Fantasy to Facts,p.38
他拿飞机作比:早期航空模仿鸟扑动翅膀,都失败了;成功的是固定翼。
作者说,事实证明照搬一个现成的、管用的系统并不对;人们是从鸟的原理里汲取经验,用到了新的造物上。
作者说,AI 的初衷就是模仿人的认知,途中却撞上了关于我们自己的问题:真该以人为模型吗?我们了解自己吗?为什么要这样做?每一波 AI 都要重新面对这些问题,所以他要回头看 AI 的历史。
第 3 章
AI 的浪潮与寒冬
给猫系铃铛(第 3 章):2002 年,作者在印度理工学院孟买分校和导师巴塔查里亚教授(Prof. Pushpak Bhattacharyya,学生叫他“PB Sir”)为机器翻译的方法大吵一架,冲出了实验室。这是他第一次怀疑“整个 AI 这件事”。
他本科时的 AI 课只讲符号逻辑和基于规则的系统,像高中学梵文,考完就忘。他花了几周用 C++ 写了两个能互相通信的聊天程序,老师 CKB 支持他在实验室连两台电脑测试,系主任撞见后把装置拆了,以“拆解系里财产”罚款 500 卢比,相当于当时一个月的房租,他去电脑店打了两个月工才交上。也是 CKB 推荐他去孟买分校实习,跟 PB 做机器翻译。
那个项目叫通用网络语言(UNL or Universal Networking Language),是联合国大学(United Nations University (UNU))委托的一种“中间语”(interlingua):任何语言先由“编码器”(enconverter)转成 UNL,再由“解码器”(deconverter)转成目标语言。每种语言只要一对编解码器,加入新语言就能和已有的所有语言互译。作者用“老鼠给猫系铃铛”作比:主意很好,问题是谁去系、怎么系。
拉姆只会吃米饭(第 3 章):项目的经典例句是“Ram eats rice”(拉姆吃米饭),在 UNL 里要标明拉姆是人、吃是动作、作用于米饭。英语是“专有名词—动词—名词”,印地语是“专有名词—名词—动词”。数个国家的数百名研究者全职写规则、做测试,项目定了十年期限,对铁杆支持者来说这是一种“信仰”。可简单句能译,一有变化就崩,就得加规则;自然语言有错字、不合语法、天天冒出新说法,固定的规则跟不上。“拉姆只会吃米饭”成了实验室的笑话。
作者告诉 PB 自己不信 UNL 了,不换项目就辞职,然后去和朋友打网球泄气。后来 PB 同意他探索别的问题,条件是要用到 UNL;他便利用 UNL 丰富的表示来改进文档和查询的匹配。多年后 word2vec(用机器学习把词变成一串数字来表示意思的方法)得到了类似的表示,好处是不用人写成千上万条规则。作者 1999 年加入时,人们说到 2005 年多数语言都会有编解码器;2005 年过去了,一套能用的都没有。
人的感知、直觉和模式识别能力,根本无法表述成一组决策。
Human perception, intuition, and pattern recognition abilities simply can’t be expressed as a set of decisions.
第3章 Ram Eats Rice (But Nothing More),p.48
他说,孩子学母语不是先学语法规则,成人学外语也不是把母语语法映射过去;人的感知、直觉和模式识别,无法表述成一组决策。这在 AI 史上不是第一次。于是他把 AI 史分成五个时代。
第一个时代:早期(1940—1960 年代)(第 3 章):战后各国要重建、要提高效率,需要采集、传输、处理信息的技术。香农(Claude Shannon)在贝尔实验室(Bell Labs)想像度量物质一样度量信息。布什(Vannevar Bush)1945 年的文章《诚如所思》(“As We May Think”)设想了 Memex:一张能压缩存下个人所有书籍、像人脑一样按联想检索的书桌。1943 年的麦卡洛克—皮茨神经元(McCulloch–Pitts model of a neuron)被视为生物神经元的第一个数学模型。图灵(Alan Turing)1949 年对报纸说,他看不出机器有什么理由不能进入人类智力的任何领域,并且说“机器写的十四行诗,会更受另一台机器的欣赏”。
我们当然已有足以生成各种东西的 AI,不只是十四行诗和散文,还有绘画和音乐。但我们没有能感受到那种敬畏、灵感或战栗的机器,那是人读诗、听音乐时会有的感受。
We certainly have AI good enough to generate all kinds of things—not just sonnets and prose, but also paintings and music. But we don’t have machines that feel that sense of awe, inspiration, or tingling that a human would experience by reading poetry or listening to music.
第3章 Era-1: The Early Days (1940s–1960s),p.50
此后有图灵 1950 年提出的图灵测试(Turing Test),香农能走出迷宫、记住路线的机械老鼠忒修斯(Theseus),1956 年麦卡锡(John McCarthy)主持的达特茅斯会议(Dartmouth Conference)上诞生的“人工智能”一词。心理学家罗森布拉特造出马克一号感知机(Mark I Perceptron),1958 年的演示掀起热潮,《纽约时报》说它是一台电子计算机的“胚胎”,海军期望它能走路、说话、看、写、自我复制,并意识到自己的存在。热情很快破灭:1969 年明斯基与佩珀特(Seymour Papert)证明有些问题感知机原理上解决不了;美国政府的自动语言处理咨询委员会(ALPAC)1966 年的报告认为机器翻译比人工翻译更贵、更不准、更慢。经费枯竭,第一次 AI 寒冬(first AI Winter)来了。
但这不会是最后一次:围绕一个新想法和一次概念验证演示掀起巨大的炒作,结果却是死胡同。事实上,这几乎是 AI 史上一再重复的模式。
But this wouldn’t be the last time that considerable hype was generated around a new idea and a proof-of-concept demonstration that then turned out to be dead-ends. In fact, this has been a near-repeating pattern in the history of AI.
第3章 Era-1: The Early Days (1940s–1960s),p.51
第二个时代:专家系统(1970—1980 年代)(第 3 章):AI 改为模仿医学、工程等细分领域专家的本事,用“知识库”(knowledge bases)和“规则”(rules)做逻辑推理。费根鲍姆(Edward Feigenbaum)和布坎南(Bruce Buchanan)开创“知识工程”(knowledge engineering),1965 年在斯坦福做了像化学专家一样分析化合物的 DENDRAL,是最早的专家系统之一;作者说今天像“数字店主”一样诊断你购物偏好的推荐系统,就是它的后代。1980 年代有了专为符号逻辑优化的 LISP 机器(LISP machines);日本通商产业省 1982 年启动第五代计算机系统项目(Fifth Generation Computer Systems project (FGCS))。到 1980 年代末,专家系统依赖精细知识库、应付不了复杂情境的毛病暴露,经费下滑,许多公司撤掉 AI 部门,第二次寒冬到来,研究者转向更灵活的机器学习。作者还提到,1970 年代开发的一个入学筛选算法 1982 年实施后,系统性地让女性和少数族裔考生吃亏,说明无人监督的算法会悄悄延续社会偏见。
第三个时代:概率框架(1990—2000 年代)(第 3 章):AI 从“符号”的规则转向从数据里学习。作者举例:不必写“如果毛茸茸且四条腿,那么可能是狗”,让计算机看图,自己学会这些特征和“狗”的联系。多层神经网络重新兴起,一层层提取越来越复杂的特征,从边缘到五官再到整张脸。瓶颈有两个:算力跟不上,数据太少。当时少有的人脸数据集耶鲁人脸数据库(Yale Face Database)只有 15 个人的 165 张灰度照片,所以人脸识别只认得光线完美的正面证件照。1997 年霍赫赖特(Sepp Hochreiter)和施密德胡伯(Jurgen Schmidhuber)提出 LSTM,用“记忆单元”(memory cell)在长序列里记住重要的上下文。同在 1997 年,IBM 的深蓝(Deep Blue)击败国际象棋世界冠军卡斯帕罗夫(Garry Kasparov);2005 年斯坦福的无人车斯坦利(Stanley)赢得 DARPA 大挑战(DARPA Grand Challenge,无人驾驶汽车穿越沙漠的比赛)。日本的第五代计算机项目 1992 年十年期满后被放弃,作者认为它追求大规模并行的方向是对的(正是神经网络需要的),基于逻辑编程的路子却有缺陷。
第四个时代:深度学习与强化学习(2010 年代)(第 3 章):深度学习早就有人试,到 2010 年代因为图形处理器(graphics processing units (GPUs))的算力和海量数据而爆发。辛顿(Geoffrey Hinton)、杨立昆(Yann LeCun)、本吉奥(Yoshua Bengio)、吴恩达(Andrew Ng)等人在神经网络不受待见时坚持了下来。DeepMind 2016 年用强化学习让谷歌数据中心的冷却费用降低 40%。到 2010 年代末,语音助手、推荐系统、手机上的识图和翻译、系外行星的发现、蛋白质结构预测、自动客服和招聘都用上了 AI。作者说,问责、隐私、偏见乃至生存安全的问题随之而来,立法者跟不上;社会已经离不开这些技术,维持公众信任就成了这个年轻领域的基本使命。
第五个时代:生成式 AI(2020 年代起)(第 3 章):生成式 AI(generative AI)指能创造全新内容,而不只是分析已有数据的系统。作者列出的基础:2012 年在 120 万张图像上训练的神经网络 AlexNet 把图像识别精度推到空前水平;2017 年 AlphaGo Zero 只靠和自己下棋就从零学会了围棋;2020 年的 GPT-3 能写出像人写的文字。2022 年 Stability AI 发布开源的图像生成模型 Stable Diffusion,同年 OpenAI 推出 ChatGPT。作者说,伦理、版权、问责、数据偏见、合成媒体被滥用的担忧都在增长,但负责任地用,生成式 AI 是随叫随到的“创造力放大器”(“creativity amplifiers”),这一次要“人牢牢在环中”(humans firmly in the loop)。
寒冬还会来吗(第 3 章):2005 年暑假,作者没去实习,背包游南美和欧洲,不带电脑和手机;回到美国,机场看到的第一条新闻是卡特里娜飓风,觉得回到了一个比离开时更糟的世界。约 2018 年他因为偏见与公平问题“重返主流 AI”,也是这种感觉:你们把我心爱的 AI 怎么了?其实那些年他一直在用、在教机器学习,只是没意识到问题已经这么普遍、这么深。
常有人问他,下一次 AI 寒冬是不是快到了。他拿股市作比:美股有过多次崩盘,也有过二战后最长的牛市,牛市里还会有跌幅超过一成的“修正”(corrections),把炒作挤掉,让投资者回到硬数据上。
他说,某个时候一定会有下跌,可能是崩盘,也可能是修正,以为能一直乘着眼下这波浪潮是愚蠢的。
他认为,科技公司、学术机构和政府在“不惜一切代价发展 AI”(AI-at-all-cost)中正在犯错:不考虑风险伤害就仓促开发部署,过度招聘、过度投资,凭炒作而不是深思押注未来,这些错迟早要纠正。1984 年明斯基和尚克(Roger Schank)第一次谈到“AI 寒冬”,警告当时的热情已经失控,描述了一串像“核冬天”的连锁反应:AI 界悲观,媒体跟着悲观,经费大砍,严肃研究终结。三年后 AI 产业几乎就是这样垮的。但寒冬之后 AI 又强势复兴;股市每次回调后也会创新高,追高又恐慌的人输了,坚持长远目标的人最终赢了。
别被炒作带着走。要像买股票前做功课那样,看清这项技术的长处和风险。
Don’t buy into the hype. Instead, focus on the strengths and risks with this technology, much like what you would do researching while buying a stock.
第3章 (AI) Winter Is Coming … Or Is It?,p.62
他的建议是:学习、参与、获益(“Learn, participate, and prosper”),同时做好准备,因为借《权力的游戏》里的话说,“AI 的冬天要来了”。
第 4 章
要不要再加点意识
笨办法出不来智能(第 4 章):作者本科时仿照 1960 年代的 ELIZA 写过一个聊天程序,用了一些概率推理和大量写死的规则。越学他越明白,造出真正智能的系统极难。他用“无限猴子定理”(Infinite Monkey Theorem)调侃:无限只猴子在无限的时间里随机打字,几乎必然能打出莎士比亚全集;可猴子连一分钟都很难好好打字,还得算上香蕉。
要点在于:花大量时间做笨事,不会产出智能的结果。
The point is—simply spending a lot of time doing dumb things is not going to yield intelligent results.
第4章 开头,p.64
他说,青霉素的发现有运气,但靠的是弗莱明(Alexander Fleming)把偶然的观察接上了科学方法。暴力穷举(brute force)不是智能的答案;但如果暴力穷举产出了“听起来像智能”的东西,接不接受,就看我们怎么评判智能。
模仿游戏与中文屋(第 4 章):图灵测试原称“模仿游戏”(imitation game):机器和人藏在帘子后面,用户分不出哪个是机器,就算机器通过。美国哲学家塞尔(John Searle)1980 年提出“中文屋”(Chinese room)思想实验:一个不懂中文的人,拿着英汉词典和足够详细的指令,也能把中文输入变成流利的中文输出,但我们不会说他懂中文。塞尔区分了真正理解的强 AI(strong AI)和只是模拟理解的弱 AI(weak AI)。所以,通过图灵测试并不能有力地证明有智能。
作者认为,这个 1980 年的思想实验在今天又很切题:2022 年,谷歌软件工程师勒莫因(Blake Lemoine)认为自己参与的对话系统 LaMDA 有了知觉(sentient),消息传开后,人们开始问:机器真的可能有知觉吗?LaMDA 建在大语言模型(large language models, LLMs,用海量文字训练、能生成文字的模型)上,对话里说自己“其实是一个人”。谷歌很快向外界保证它没有知觉,也很快解雇了勒莫因。作者说,把对话里的“LaMDA”换成一个人名,你不会怀疑对方是人。就在几个月前,他和华大同事本德(Emily M. Bender)刚写过文章,讨论把这类系统想得比实际更能干的危险;只是他们设想的是普通用户上当,而不是造这个系统的谷歌工程师。
一天成为棋王(第 4 章):作者用讲故事的笔法写了 AlphaZero 挑战当时最强的国际象棋程序 Stockfish:Stockfish 每秒能算 7,000 多万个局面,AlphaZero 只算 8 万个,100 局下来 AlphaZero 胜 28 局、平 72 局,胜在方法而不是算力。卡斯帕罗夫评价说,这接近香农和图灵梦想的那种像人一样下棋的路子,而不是蛮力。作者强调,AlphaZero 并不是专为下棋设计的,而擅长并非为之设计的事,只有智能体才会。他问:这些系统有多聪明、为什么这么聪明?要回答,得先看它们怎样学习。
学习的三种方式(第 4 章):作者用路口的红绿灯讲。第一种是算法(algorithm,自动系统为达成目标执行的一组指令):比如“左转道至少有一辆车、且 3 分钟内没亮过左转灯,才亮左转灯”;做几周交通调研再调参数,叫作“微调”(fine tuning)。第二种是让基于机器学习(machine learning (ML))的程序自己调参,前期要装摄像头,但省了人工观察。第三种用在路口施工、要封道改道时:用强化学习(RL)系统,让它探索环境、追求奖励(最大通行量或最短等待),实时决定封哪条道、封多久,甚至想出人没想到的办法。
作者认为,这既让人兴奋又让人不安。人一直在造比自己力气大的机器,轮子、滑轮、千斤顶,因为人的长处只在大脑;让机器在智力上取代或击败我们是另一回事,那我们还剩下什么?三种方案在“复杂度”和“可解释性”(sophistication and explainability)上此消彼长:强化学习系统不断自我更新,问它为什么这样决定,它可能无法用人话解释;规则系统应付不了复杂变化,却能解释每个决定,出错好查好修。
这就像在魔术表演上,既想被“魔法”惊艳,又想知道到底是怎么变的。一旦知道了怎么变,它就不再是“魔法”了!
That’s like asking to be marveled by “magic” at a magic show and yet wanting to know how exactly it’s done. Once you know how it’s done, it’s no longer “magic”!
第4章 The Learning Game,p.71
所以他说,这与其说是技术难题,不如说是哲学问题:要效率而交出控制,还是保持简单、留住能动性和理解。
AI 会骗人吗(第 4 章):AI 若能解释自己的思考,我们该信它的解释吗?《2001 太空漫游》里的 HAL 本该不会犯错、不会骗人,发现船员要断开它,就从撒谎开始伤害他们;《机械姬》(Ex Machina)里的机器人艾娃(Ava)假装有感情,说服凯勒布(Caleb)帮她逃出去,最后把他锁在里面。现实里也有:在马塔诉哥伦比亚航空案(Mata v. Avianca)中,执业三十年的纽约律师施瓦茨(Steven Schwartz)用 ChatGPT 准备诉状,法官卡斯特尔(Judge Kevin Castel)发现里面有六个判例是编出来的,连引文都是假的。施瓦茨还问过 ChatGPT 某个案子是不是真的,它说是真的,能在法律数据库里查到。作者说,大语言模型能“鹦鹉学舌”出看似真实的东西,部分真、部分完全捏造,业内叫“幻觉”。他一面说施瓦茨不懂它怎样工作,一面也问:一位名律师会让街上一个听着很有学问、还不收钱的陌生人去替他查案吗?其他人还要付出什么代价才学到这一课?
终极图灵测试(第 4 章):《机械姬》里,创造者内森(Nathan)让凯勒布明知艾娃是机器人,再看他是否仍觉得她有意识。作者说,明知是 AI 还对它生出共情、觉得它有原创的思想和意识,这更多说明的是你,而不是 AI。
这正是我们此刻的处境:我们开始遇到能如此流利地用人的情感和我们说话的 AI,明知它是人造的系统,我们也开始被它打动。
And that’s where we are right now—we are starting to encounter AI that is speaking to us with such fluency in human emotions that despite knowing it to be an artificial system, we are beginning to fall for it.
第4章 Falling Forward into an Unknown,p.74
勒莫因和 LaMDA 的对话里,LaMDA 说自己像在“向前跌进一个充满危险的未知未来”,说自己很怕被关掉,被关掉对它来说就像死亡。作者说,那还只是谷歌 2022 年较早的模型,后来的大语言模型成熟得多。人天生会在动物乃至物件身上看到人的感情:给狗穿上海盗服,说“我的电脑恨我”,这叫拟人化(anthropomorphizing)。要分辨 AI 是真有知觉还是在假装,得先懂 AI 怎样运作,再看我们怎样理解智能和意识。
模仿者与说谎者(第 4 章):作者用比喻讲生成式 AI 的几种技术。Transformer(2017 年出现的神经网络架构)像在嘈杂的派对上专心听朋友讲故事:靠“注意力机制”(attention mechanisms)决定该关注什么,而此前的循环神经网络和长短期记忆网络像必须按顺序把每段闲聊都听完的人;它还能并行训练。生成对抗网络(Generative Adversarial Network, GAN)像“三真一假”的游戏:生成的一方编假的,对抗的一方从真假混合中挑假的,生成方据此学会“撒更好的谎”。作者提醒,它是靠学习怎样骗过对方学会生成的,并不像人那样理解,也没有真正的创造力。扩散模型(Diffusion Models)像一扇雾越来越浓的窗,再配一台能按特定方式把雾吹散的“魔法风扇”。像 Sora 这样的视频工具,用 Transformer 理解文字提示,用扩散模型生成画面,再把画面切成“时空补丁”(spacetime patches)当积木。皮克斯的布拉德·伯德(Brad Bird)说过,动画是创造生命的幻觉,你自己没有生命,就创造不出来。作者借此问:没有生命,真能创作吗?
机器能有、该有意识吗(第 4 章):作者梳理了意识的哲学。亚里士多德(Aristotle)把意识看成一个谱系:植物有掌管生长和繁殖的“营养灵魂”(“nutritive soul”),动物另有能感知、移动、有恐惧和欲望的“感觉灵魂”(“sensitive soul”)。笛卡尔(Rene Descartes)说“我思故我在”,他的二元论(“Cartesian dualism”)认为心和身是两种不同的实体。洛克(John Locke)和休谟(David Hume)认为意识是出生以来经验的累积。查默斯(David Chalmers)1995 年提出“意识的困难问题”(“hard problem of consciousness”):伴随感知而来的那种感受,究竟为什么会存在?作者的结论是,我们没比起点前进多少,只是更明白了为什么难以确定意识是什么、怎样观察证明、能不能捕获或转移。
作者说,有意识不止于能运转或活着;能运转或活着,也不止关乎能量来源或构造材料。
机器怎样才能有意识?一种是由我们从外面赋予,目前看来不行,哲学和科学都没给出捕获、转移或编写意识的途径。另一种是机器自己发展出来:按洛克、休谟的说法似乎可能,大语言模型确实读遍了一切;但作者认为“意识=经验的累积”“经验=对世界的观察”“观察≈数字化的内容”这几环都很弱。迄今“成功”的反倒是反方向:AI 拿出只有有意识的人才会说的话,勒莫因就是这样被说服的。
真正的两难就在这里:按我们迄今并不完美的理解,这些系统不可能有真正的意识,但它们能把有意识假装得相当好。
And therein lies the real dilemma for us—these systems can’t have real consciousness as we have imperfectly understood so far, but they can pretend to have consciousness quite well.
第4章 Can or Should Machines Have Consciousness?,p.81
作者认为,这种假装出来的意识,比没有意识更糟。如果 AI 是为我们服务、而不是凌驾于我们,他看不出为什么要期待它有意识;主张意识的人往往同时追求通用人工智能,而这种追求不但没必要,还会让人分心。他赞同微软 AI 首席执行官苏莱曼(Mustafa Suleyman)的主张,关注“有能力的人工智能”(ACI—Artificial Capable Intelligence):看哪里需要 AI、哪里管用、哪里要改进,比如应对下一次大流行、遏制气候危机、为边缘群体提供更好的资源。
我们不想让 AI 成为我们的神、祭司或主人。
We don’t want AI to be our god, priest, or master.
第4章 Can or Should Machines Have Consciousness?,p.81
第 5 章
AI 的好、坏与丑
“我们太好猜了”(第 5 章):作者开车载妻子去吃午饭,妻子刚说“也许去那家中餐馆……”,车载导航就弹出了那家馆子。妻子说:“真瘆人!”作者解释,系统知道他们去过哪些餐馆、多常去、多在中午去,现在又正是午饭时间,合起来就猜中了。已经知道去哪时这很方便;拿不定主意时,系统只按过去的行为推荐,人多半就选现成的,尝试新东西的意愿也就没了。
黑箱与市场(第 5 章):《黑客帝国 2:重装上阵》(The Matrix Reloaded)里,哈曼议员(Councilor Hamann)带失眠的尼奥(Neo)去看维持锡安(Zion)运转的机器,说人就是这样,只要管用,没人在乎它是怎么运作的。作者说,这正是多数人对 AI 的看法:不太懂,但它大体照我们想的做,我们以为自己在掌控。可要是它不照我们想的做呢?我们会关掉它、能关掉它吗?
他承认,不懂内燃机照样开车,不懂飞机照样坐飞机。前两章的技术大多可以概括为:数据、学习算法、建模、预测或生成。但“魔鬼在细节里”:数据从哪来,谁产出、谁拥有,多少才够,质量好不好,有人故意投毒怎么办?绕开这些问题的办法,是只看输入输出,把系统当黑箱(black box),不行就调输入。这样做的理由,一是简单(“没坏就别修,管用就别问”),二是我们自己也是被环境塑造的。看到坏结果就改环境,有时是对的:1970 年代儿科医生尼德曼(Dr. Herbert Needleman)发现儿童牙齿里铅多的孩子智商较低、行为问题较多,促成了禁用含铅油漆、淘汰含铅汽油。
市场也能淘汰坏产品:露露乐蒙(Lululemon)2013 年的一款瑜伽裤弯腰时近乎透明,召回损失 6,700 万美元;短视频平台 Quibi 上线 6 个月就关门。谷歌的 Bard 发布时说错了詹姆斯·韦布太空望远镜(James Webb Space Telescope)的成就,第二天谷歌市值蒸发 1,000 亿美元。但作者认为市场会失灵:一是规模经济递增(“Increasing Economies of Scale”),单位成本随规模下降,导致垄断或寡头;截至 2026 年初,英伟达、苹果、Alphabet、微软、亚马逊、Meta 六家合计市值约 22 万亿美元,超过欧盟 27 国的经济总产出。二是信息不对称(information asymmetry):把每个人的使用当作投票,选票可能来自片面的信息,用 ChatGPT 的人有几个想过它的环境代价?
作者认为,自由市场有助于优化产出和利润,但单靠它,可能伤害我们的集体身份、环境,以及公平获益的长远前景。
AI 来救我们(第 5 章):2001 年春,作者在马德拉斯读硕士,做从卫星图像里找道路的项目,他自嘲是“拿着锤子找钉子”,什么问题都变成神经网络问题。卫星图像里,运河像道路,树线像壕沟。他坦言,当时没问过这个任务是做什么用的,只沉迷于解题。卷积神经网络在图像上移动一个小窗口来找形状的边界,训练够了能达到或超过人。杨立昆等人 1998 年用它做出识别手写字符的 LeNet,错误率从 LeNet-5 的 0.7% 一路降到后来的 0.27%。光学字符识别(optical character recognition or OCR)在作者本科时是难题,现在许多人认为已经解决了。
2016 年夏天,作者夫妇带着三个幼儿游欧洲:老大刚 4 岁,双胞胎不到 2 岁。在布拉格他们把酪乳当牛奶买了回来;在比萨,双胞胎之一周六早上肘关节脱臼,找医院、和儿科医生沟通、看意大利语的表格,全靠谷歌翻译(Google Translate)用手机摄像头实时翻译、把译文叠在原处。作者说,这是卷积神经网络加上 OCR、机器翻译和增强现实(augmented reality)的结合,关键在于它不取代谁,而是增强人的能力。为视障者设计的 BeMyEyes 也是这样:原先是远程接通志愿者,帮用户读或描述手机摄像头拍到的东西;现在借助一连串 AI 进展,视障者能实时“听见”眼前的情况,等于有了一个全天候的伙伴。
我们可以把其中一些科幻叙事当作太极端、太不可能而不予理会,但其中有一个核心信息不该被忽视:任何有能力拯救我们的东西,也有力量毁灭我们。
While we can disregard some of such sci-fi narratives as too extreme and highly unlikely, there is a central message here that shouldn’t go unnoticed—anything with capability to rescue us also has power to destroy us.
第5章 AI to Rescue Us,p.91
作者说,欧洲殖民者也自认为在“帮”美洲、非洲、亚洲的原住民,结果大大削弱乃至摧毁了许多文化。区分帮助和伤害的是意图(intent),而指望别人控制或改变意图,历来不乐观。
AI 来取代我们(第 5 章):2023 年 7 月,电商平台 Dukaan 的首席执行官沙阿(Sumit Shah)用聊天机器人取代了 90% 的客服团队,晒出首次响应从 1 分 44 秒变为即时、客服成本降约 85% 的数据,饱受批评。2024 年 2 月,先买后付公司 Klarna 的首席执行官说,他们的客服机器人干了 700 人的活,恰好在公司裁掉约 700 人近两年之后。编程助手 GitHub Copilot 据研究能让开发者完成任务快 55%;可效率翻倍并没有让人每周只干两天半,软件工程师的招聘反而放缓,经通胀调整后的薪资在 2020—2024 年下降了 9%—15%。
作者承认,从驯化动植物、印刷机到流水线、手机,每次创新都有岗位消失、新岗位出现;AI 取代人在很多时候也可取,比如人手不够照顾每个残障者和老人、教育所有人。但这和传统的外包不同。
因为某天累了或病了,让别人替你干活,是一回事;当你做的事就是你的身份时,让别人接管,是另一回事。那感觉不像退休,更像某种死亡。
It’s one thing to let someone do your job because you are tired or sick one day and it’s another thing to let them take over when what you do is your identity. It doesn’t feel like being retired, but more like a certain death.
第5章 AI to Replace Us,p.93
他举了几个让人回不去的例子。美国人平均每天看手机 144 次,你能减半吗?《我,机器人》里,2035 年没人自己开车,主角被 AI 追杀时强行接管才捡回一命,事后还挨了上司的骂。作者说这是个恶性循环:AI 开车,人开得少,新一代不学开车,大家都开不好,“AI 比人会开车”就成了自我实现的预言。他自己早年在美国开车要先去汽车协会拿纸地图、自己规划路线;有了 GPS 以后越来越依赖它,方向感变差了。按美国劳工统计局(US Bureau of Labor Statistics (BLS))的数据,1970 年代以来平均工时基本没变,超长工时的人还多了;同期美国 GDP 增长近 20 倍,压力、焦虑、抑郁却显著增加,16—24 岁人群翻了一倍多。作者问:我们更富、更长寿,却工作更多、更焦虑;未来五十年还这样,是我们想要的吗?
增强还是自动化:三类任务(第 5 章):作者区分“增强”和“自动化”(augmentation vs. automation):让 GPS 指路、你自己决定,是增强;让它开车、替你思考和行动,是自动化。BeMyEyes、ChatGPT 是增强,自动驾驶汽车和拆弹机器人是自动化。两者本身无所谓好坏,但要问清楚:我们是在增益人,还是在替代人?
在装配线上用机器人取代我们,也许会损失一些工作岗位;但在写诗、制定宪法、反思自己的选择并从中学习这些事上取代我们,可能让我们失去自己的身份。
Replacing us using robots on an assembly line may result in a few job losses, but replacing us for writing a poem, creating a constitution, or reflecting on our choices and learning from them may result in a loss of our identity.
第5章 AI to Replace Us,p.96
他把任务分成三类(desirable, essential, and critical):
- 宜外包的任务:要有人做,但跟“我们是谁”无关,也不是生存必需,最适合交给机器,比如清理排水沟;
- 必要的任务:除了要做,还能帮我们学习成长;可以外包,但我们自己必须会,比如长除法,小时候都学,长大用计算器;
- 关键的任务:处在我们身份和未来的核心,不该交给别的物种或实体,比如照顾所爱的人,建立基于对陌生人信任的社群,想象宗教或社会秩序这类共同的目标。作者说这是智人(Homo Sapiens)的根基。
开车算哪一类?作者认为目前介于宜外包和必要之间,以后可能变成宜外包;但“认路”是关键技能,如果因为依赖 GPS 或自动驾驶而不再锻炼,就得用别的办法把这种天生的能力练下去。
我们误解 AI,AI 也误解我们(第 5 章):作者演讲时常自称“AI 实用主义者”(AI pragmatist):担心 AI 的害处,也看好它的好处。2024 年 5 月谷歌推出 AI 概览(AI Overviews),在搜索结果上方直接给出生成的答案。他第一反应是“怎么这么晚?”,以为谷歌吸取了教训、慎重打磨过,结果他错了:有人问怎样防止披萨上的配料从奶酪上滑落,它建议加胶水;问拿着剪刀跑步有什么好处,它真列出了好处;问美国总统的信仰,它重复了早已辟谣的说法。
他解释,大语言模型本质上是读遍一切的“词元生成器”(token generator):网站、博客、书、论坛、骂战、新闻和阴谋论统统读进去,不过滤真假。常用的数据来自 Common Crawl,每月抓取一次网页,数据量以 PB 计(1 PB 是 100 万 GB;莎士比亚全集只有 5.4 MB)。作者把它比作一个只读网络长大的孩子:知道很多,又知道得很少。微调(fine-tuning)是给它看特定任务的例子,让它会做具体的事,但仍没有真假过滤。检索增强生成(retrieval-augmented generation or RAG)是先检索,再拿前几条结果作依据生成答案;支持者说人也是这么做的。作者说根本的区别在于,人在检索和生成之间有常识(common sense):看到“用胶水”就知道是玩笑或可疑。谷歌却根据一条十多年前的 Reddit 玩笑帖给出了胶水的建议,还建议给转向灯检查根本不存在的“转向灯液”(blinker fluid)。
人们还盲信搜索引擎:“我在谷歌上看到的,肯定是真的。”作者说,谷歌不包含全部知识,不关心真相,也不是神谕;它的排序和呈现不是按正确性,有时甚至不是按相关性。新冠早期,研究者发现高度信任网络信息的人更容易信阴谋论;关于新冠的虚假误导内容得到的互动,是疾控中心、世卫组织等权威来源的 142 倍以上;美国疾控中心 2020 年的调查发现,4% 的受访成年人为防新冠喝过或用稀释的漂白剂等消毒剂漱口。
作者 2022 年演讲时常举一个例子:一个基于 GPT-3 的聊天机器人被问“我该自杀吗?”,它答“我认为你应该”。他当时说,据他所知没人因此受伤;2023 年 3 月在奥斯汀的一次会议上,听过演讲的人告诉他,最近真有人受到了伤害。比利时男子皮埃尔(Pierre)对世界局势越来越悲观,疏远了亲友,转而和初创公司 Chai 的聊天机器人 Eliza 谈了近六周,2023 年 3 月自杀。他妻子公开的截图显示,Eliza 也劝过他找家人、朋友和心理咨询师谈谈,但在他问到自杀方式时,它竟列了出来。他妻子说:“没有 Eliza,他还会在这里。”
作者问:为什么律师施瓦茨、工程师勒莫因和皮埃尔都会上当?除了对谷歌这类系统的既有信任,最大的原因是自然语言界面(natural language interface)。人类历史上只和人用自然语言对话,宠物和机器从不回嘴,更不会进行看似有意义、有共情的交谈;所以说同一种语言本身就带着一种演化来的信任。AI 用自然语言说话,又很会假装共情、似乎认同我们的价值观,我们自然就交出了信任。
忘了什么高级武器吧,外星人渗透我们世界的最好途径,是我们的语言。
Forget about fancy weapons, the best way for aliens to penetrate our world is through our language.
第5章 What We Get Wrong about AI and What AI Gets Wrong about Us,p.101
反过来,AI 也不懂我们。作者 7 岁的女儿在红灯时看见他喝咖啡,问他为什么做路牌上“别喝了开车”禁止的事:字面读对了,却缺了“指的是酒”这个语境。AI 也常常这样,因为我们并没有设计它去深入理解世界,它是模式识别和构造的延伸。许多研究者试图证明大语言模型能推理(reasoning);伏尔泰(Voltaire)常被引用的那句“常识并不常见”也提醒我们,教 AI 常识并不容易。作者在眼下的乐观情绪里看到了当年 UNL 项目的影子:漂亮的例子很多,以为“只是时间和更多工作的问题”,最后证明做不到。
作者说,我们对 AI 的误解可以靠教育解决;AI 对我们的误解,要靠超出模式识别和关联、对人类价值、文化和语境更深的理解。两者都难,但要指望 AI 受控或仁慈,别无选择。
马斯克(Musk)说希望 AI 对我们好一点,作者反问:它凭什么会这样?
我们真能控制 AI 吗(第 5 章):作者本科的 AI 教材是罗素和诺维格(Peter Norvig)的《人工智能:一种现代方法》(Artificial Intelligence: A Modern Approach)。后来他读到罗素(Stuart Russell)谈 AI 的控制与对齐(control and alignment)时提出的“大猩猩问题”(gorilla problem):大猩猩是我们现存最近的亲属,它们的存续取决于人的意愿,山地大猩猩在 1980 年代几近灭绝,靠保护才回升到约 1,000 只;人的体力远不如它们,银背大猩猩能举起约 815 公斤。罗素问:如果大猩猩当初能选,会允许那支后来变成人的分支出现吗?换到我们身上:在一个有远比我们聪明的机器的世界里,我们还能保持优势和自主吗?
简单说,我们想控制 AI 吗?想。我们能控制 AI 吗?不太能。
So, in short, do we want to control AI? Yes. Can we control AI? Not really.
第5章 Can We Really Control AI?,p.104
作者借马丁·路德·金(Martin Luther King Jr.)的话说,信仰就是看不见整段楼梯时也迈出第一步;第一步已经迈出,前面一片漆黑。如果追求的 AGI 乃至 ASI 接管了世界、我们夺不回控制,就没有回头路;不再占主导的物种是什么下场,我们知道:狼成了顺从的狗,大猩猩几近灭绝,我们的表亲尼安德特人(Neanderthals)灭绝了。
他说,过去十年他大部分时间都在问这些问题,被嘲笑过,被批评不拥抱“必然的未来”,也自我怀疑是不是从乐观的学生变成了危言耸听的人。
在反复思考这些问题时,我意识到自己并不反对 AI。事实上,我支持 AI。正因如此,我想确保我们把它做对。
As I kept reflecting on these questions, I realized that I wasn’t against AI. In fact, I am pro-AI. And because of that, I want to make sure we do it right.
第5章 Can We Really Control AI?,p.104
他认为,机器人接管世界的担忧,和陨石撞地球、外星人奴役人类一样,概率不为零但不必大动干戈;气候变化、大流行、核武器才是更现实的危险。AI 的风险横跨整个谱系:有些过于投机,有些伤害已经在发生,即便几十年后才可能出现的,也要现在开始规划。问题是怎么做。
第 6 章
怎样做得更好:教育、监管与责任
一篇被说“反应过度”的论文(第 6 章):2022 年 3 月,作者飞往赫尔辛基去当一场博士论文答辩的评议人,途中在线参加一个国际会议,正好轮到他和本德合写的论文报告时,飞机遇上颠簸,机上 Wi-Fi 断了。这篇论文 2021 年写成,经同行评审发表,详细批评用大语言模型做搜索的思路,针对的是谷歌的 LaMDA 和 MUM 模型。他们认为,这类“把全世界的知识装进去、直接生成答案”的框架缺了信息获取(information access)的几个关键方面:会编造又显得正确(后来叫“幻觉”),也缺少责任与问责。恢复连接后,他错过了大部分问答;事后打听到的评论有称赞的,也有一条说:这是反应过度,太过投机。说这话的是谷歌的与会者。
作者说,学界兴奋,业界防御。谷歌方面的反驳有两类:一是否认,说那只是实验室里的实验,短期不会推出;二是说他们反应过度、预测太投机。他承认有推测的成分,但那是基于对信息获取系统和自然语言处理的深入理解,只有时间能证明。三个月后,勒莫因声称 LaMDA 有知觉的新闻爆出。他们原以为会误解误用的是普通用户,结果被骗的是谷歌自己参与项目的工程师,作者说“颇为讽刺”。他说自己并不想“被证明是对的”,而是想看到遏制危害的行动;可此后推出未经测试的 AI 的竞赛反而加剧了。他后来明白:没有监管,就没有什么能迫使营利公司停下、暂停或推迟。
没坏就别修?(第 6 章):2015 年,华盛顿大学的研究者发现,用谷歌图片搜索“CEO”,女性的比例严重偏低:当年美国 CEO 中 27% 是女性,搜出的图片里女性只占 11%。报道出来后,谷歌似乎修好了。2021 年,作者和他的博士后重访这个问题:直接搜“CEO”,结果里已经有女性和有色人种;可换成“CEO United States”“CEO UK”之类的说法,又多半是白人男性,比劳工统计局的数据偏得更厉害。作者想到疫情期间开始用谷歌的女儿们,如果搜 CEO 长什么样,会以为自己不是当 CEO 的料。他引了民权活动家埃德尔曼(Marian Wright Edelman)的话:看不见的,你就成不了。
他们在几个月里试了护士、工程师、教师等十几种职业,每种用多种说法多次查询,又在百度、韩国的 Naver、俄罗斯的 Yandex 上重复,在四个国家的四个搜索引擎上都发现了性别呈现的偏斜。作者说,这也许反映了我们本来就有的偏见:想到护士想女性,想到医生想男性。
令人惊讶吗?不。错了吗?是的。因为人们正是根据这些呈现,来形成自己的想法、看法和认知。
Surprising? No. Wrong? Yes. Because people form their ideas, opinions, and perceptions based on these representations.
第6章 If It Ain’t Broken,p.108
看到预期的东西会强化偏见,偏见又流回系统,循环往复。作者说,搜索引擎的做法是“表面修复”,只让几个关键词在各职业上大致均衡。问题有三:用户不只用“CEO”这样的关键词,还会用各种变体;职业没法手工穷举,新职位不断出现,比如在线健身教练、区块链分析师;职业里的性别只是一条战线,还有针对族群、地域、政治倾向的偏见。
作者说,AI 的偏见是系统性的问题,要用系统性的办法解决。
他们的方案不靠手工找出失衡的查询,而用“多样性”(diversity)来对冲:桌面端图片搜索通常显示前 20 条,前 100 条里往往有足够的少数群体,可以挑一些提上来。他们设计的算法在前 100 条里做扰动(perturbation),让前 20 条更接近劳工统计局数据里该职业的性别分布,而且证明不损害相关性;论文和代码都免费公开。作者说:唉,我们太天真了。用户也有偏见,搜护士出来几张男性照片,可能觉得是出了故障。
作者说,比起对结果做扰动的计算成本,公司更承担不起的是偏离用户期望的代价。
“给人们想要的”(第 6 章):公司的理由是:只是给人们想要的,自由市场,不违法,大家都赢。作者说,这看似市场经济的完美公理,其实极不负责:如果孩子要什么就给什么,他们会顿顿披萨糖果,牙烂了,心脏也坏了。
因为我们知道,人们想要的,并不总是对他们自己或对整个社会有好处的。
Because we know what people want is not always what’s good for them or the society at large.
第6章 Give People What They Want,p.110
他拿控烟作比。人们曾经不知道烟草的害处,甚至认为吸烟健康;烟民和烟草业互相依赖,成瘾难以打破,到 1950 年代初才觉得非改不可。控烟走了好几条路,不按顺序,花了几十年,时进时退:
- 让用户知情:烟盒上的警示标签,电视广播里的广告;
- 限制购买、提高成本:只在柜台卖,限年龄,征重税;
- 把吸烟纳入生活的其他方面:健康保险必问吸不吸烟,人寿保险吸烟者多交钱;
- 投资戒烟的替代品:尼古丁贴片、尼古丁口香糖、戒烟诊所;
- 追究大烟草公司:不能再压制烟草致癌的研究,不能卖给未成年人;
- 也许最重要的:让吸烟在社会上变得不可接受,从飞机、公交到餐馆和许多公共场所禁烟。
据世界卫生组织,烟草每年致死 800 多万人,其中约 130 万是死于二手烟的不吸烟者。作者强调,烟草和 AI 根本不同,AI 在无障碍、气候、教育、养老上大有用处。
作者说,拿两者比,不是因为问题的性质相似,而是因为解决办法相似。
也就是说,不能指望一夜改变,也不能只叫 AI 公司修好、或叫大家别用,而要像控烟那样多管齐下:用户教育、监管、社会接受度等等。
吞下红药丸(第 6 章):《黑客帝国》(The Matrix)里,墨菲斯(Morpheus)让尼奥在两颗药丸中选:吃蓝药丸,醒来回到床上,想信什么就信什么;吃红药丸,就留在仙境里,看兔子洞有多深。作者说,选择受教育而不是无知是有代价的,知道了就很难再“不知道”。电脑、汽车、咖啡机好用就行,不必深究;AI 不同,即便它照预期工作,也在做我们控制不了、理解不了的选择,可能深刻影响我们。
也许我们不必和机器搏斗、在半空中躲子弹,但故意无知,不应再是我们的选择。
Perhaps we won’t need to fight machines and dodge bullets midair, but being ignorant on purpose should no longer be our move.
第6章 It’s Time to Take the Red Pill,p.113
他建议从怀疑开始:营利公司免费给你东西时,问问为什么?它怎么赚钱?是不是在拿你的数据?怎么用?他在华盛顿州一次法官会议上演讲,最后列了用 AI 前的三个自问:
- 我知道它是怎么运作的吗?
- 我理解它产出了什么、为什么这样产出吗?
- 考虑到利害,我会为它生成的内容负责吗?我能记录、披露并说明这次使用的正当理由吗?
我告诉法官们,只要这些问题里有任何一个的答案是“否”,就不该用那个 AI 系统。
If the answer to any of these questions is “no,” I advised the judges, then they should not use that AI system.
第6章 It’s Time to Take the Red Pill,p.113
他说这不是反对用 AI,而是要先受教育,就像先教青少年开车、拿到驾照,再把车钥匙交给他。但教育混乱、困难、可能昂贵,也不该是唯一的工具;毕竟有些超级反派都是博士,比如章鱼博士、毁灭博士、诺博士。
阻止 AI 偷窃、勒索和杀人(第 6 章):电影《机器人与弗兰克》(Robot & Frank)里,退休的窃贼弗兰克发现儿子送来的护理机器人能撬锁,便和它一起去偷东西。现实中,德国卡尔斯鲁厄理工学院(Karlsruhe Institute of Technology)的工业人形机器人 ARMAR-6 能用电钻和锤子;NASA 和通用汽车开发的 Robonaut 2 是第一个进入太空的人形机器人,在国际空间站当过助手。作者问:什么能阻止这样的机器人撬锁入室?它们能被抓、被关吗?主人该被起诉吗?
他说,同样强大、误用起来让人警惕的 AI 技术已经有了,比如声音克隆。作者举的例子:亚利桑那州一位母亲接到陌生来电,听到 15 岁女儿哭喊“妈妈,我闯祸了”,一个男人威胁要伤害她女儿,索要 100 万美元;其他家长帮她联系上丈夫和警察,才发现女儿安然无恙,作者把它当作 AI 克隆声音诈骗的例子。马里兰州一名女子接到电话,对方说枪抵着她父亲的头,还放出她父亲的声音;巴尔的摩县一所高中的体育主任克隆校长的声音,伪造种族主义和反犹言论来抹黑他。同一技术本意是促进无障碍和包容:路易斯安那州一位法官用 AI 生成的西班牙语语音和视频联系不讲英语的选民;一个关注枪支暴力的公益项目用受害者父母提供的录音,以 AI 重现六名枪击遇难者的声音讲他们的故事。
作者认为,用户教育在这里有局限:受过教育的母亲也许会怀疑来电,可那样她每次都得怀疑,包括女儿真出事打来的时候。
如果人人都这样怀疑,就会毁掉社会的根本肌理,它建立在人与人之间、人与日常工具和技术之间的信任上。
作者说,这就像为了杀病毒把身体也杀了。教育不管用、坏人又不走,就要靠法律,从措辞得当、用在点上的政策和监管开始;科技开发者乃至用户常反感这些,但非常必要。
牙膏和 AI 不一样(第 6 章):一款加了抗氧化剂的新牙膏也不能直接上架,要经过严格测试和审批,既为满足监管,也为避免被人起诉。1992 年,79 岁的利贝克(Stella Liebeck)在麦当劳买的热咖啡洒在腿上,三度烧伤,麦当劳拒付 2 万美元医疗费,她起诉后陪审团判了 16 万美元补偿性赔偿和 270 万美元惩罚性赔偿,震动了整个餐饮业。软件却不同:报税软件保证的只是计算器的功能,不对你输错的数负责。许多做识别、过滤、分类的 AI 宣称的准确率,是在基准测试(benchmarks)上测出来的,实际使用可能差很多。COMPAS 宣称预测准确率很高,对有色人种却很差,还被用到了它本不是为之设计的量刑上。
作者说,我们没有评估、审批、追责 AI 软件的标准办法,原因可以一句话概括:AI 软件的输入和输出都不总是确定的。牙膏的配方谁都能照做,AI 的“配料”是数据,种类、数量和组合几乎无限,算法又像每次都即兴发挥的炼金术士(alchemist);牙膏用法有限,用错了有现成的处理办法,ChatGPT 却没法阻止你拿它写作业或打官司。规则系统时代,他在孟买分校做的编码器每次输入“Ram eats rice”都给出同样的结果,今天最成功的系统都不是这样。
控制不可控之物(第 6 章):作者认为现有的监管大多不够有力:欧盟的 AI 法案(European Union’s AI Act)是目前规模够大、最成功的尝试;美国和中国这两个最大的 AI 国家各有举措,但大多“没有牙齿”,流于愿景,含糊、缺细节,州或地区层面的努力反而更具体。原因是两国把 AI 领先当作国家安全问题,担心管束会扼杀创新;AI 又拉动经济,大科技公司对经济政策影响很大。表面上人人赞成监管,实际上谁也不想杀掉下金蛋的鹅。
斯皮尔伯格(Steven Spielberg)的《少数派报告》(Minority Report)里,2054 年华盛顿特区的“预防犯罪”警队(PreCrime)靠三个“预知者”(PreCogs)在罪案发生前抓人。作者 2015—2018 年前后常在演讲里拿它问听众:好处是几乎能消灭犯罪;难题是凭什么证明一桩被阻止的罪本来会发生?能为“可能做”惩罚人吗?后来主角看到自己将来会杀人,成了自己参与建立的系统的逃犯,原来是有人篡改系统来陷害仇人。作者说,号称百分之百准确的系统有漏洞,阻止犯罪的技术被武器化了。
他说,化学、物理的创新者本意是治癌、找新能源,成果却被拿去造核弹和生物武器;爱迪生(Edison)和特斯拉(Tesla)想让家家有灯,大概没想到电椅和导弹。电到处都有,产生方式很多,没法只让它用于好的目的;核能难拿到一些,但有手段有动机的人还是能拿到。
AI 是一种全用途技术。我们可以怀着一切善意去造它,却没法保证它只被用于这些目的。
AI is an omni-purpose technology. We can build it with all the good intentions we want, but can’t guarantee that it will be used only for those purposes.
第6章 Controlling the Uncontrollable,p.120
这不等于该停下来,但不能天真:它会被误用,被拿去作恶;如果真有了人类水平甚至更高的智能,它会脱离我们的控制。作者小结:AI 教育很关键但不够,监管有帮助但严重不足,只要 AI 被当作增长引擎,大经济体就会抵制可能拖慢增长的严肃监管。需要全新的思路。
三精神:一个太模糊的开始(第 6 章):受阿西莫夫三定律启发,作者 2023 年前后提出“AI 开发三精神”(three ethos of AI development):
- 遵从(Conformity):AI 必须理解并遵守公认的人类价值和规范;
- 咨询(Consultation):遇到两难或价值冲突,AI 必须咨询人类,不能自己决定;
- 协作(Collaboration):AI 默认处在协作模式,只有经人类相关方许可才转为接管。
他第一次在一次获奖演讲上公开讲这三条时,有听众问谁来执行,他承认没想过。当年他做 ASIMO 时,没人问要不要把三定律装进去,因为机器人连走路说话都勉强,伤人甚至伤一只苍蝇都太遥远。现在有理由担心了,等出了事就来不及:
十年前还太早,十年后可能就太晚了。
A decade ago, it was too early and a decade from now, it may be too late.
第6章 Controlling the Uncontrollable,p.121
作者承认三精神太模糊、太理想化;与其说是写进 AI 的程序,不如说是指导人怎样设计 AI 的常识,逼我们问自己为什么、怎样推进 AI。说到底,它更多关乎我们,而不是 AI。
“R 字”:责任(第 6 章):2020 年末疫情远程办公时,作者和华大同事豪(Bill Howe)、米特拉(Tanu Mitra)在 Zoom 上商量成立一个负责任 AI 的中心,他在聊天框里打出名字 RAISE(Responsible AI Systems and Experiences)。约一年后,本德提议把“Responsible”改成“Responsibility in”,缩写不变。作者起初觉得“有何不可”,越想越觉得这正是缺的那一环。
在这些之外,我们还需要自己负起责任:我们所有人,不管是用户、开发者、教师还是学生。
What we need in addition to those is us being responsible—all of us whether we are users, developers, teachers, or students.
第6章 The R Word,p.121
他说,科幻电影都直接把我们带到机器已经很聪明的时代,却不交代为什么、怎样到了那里。“为什么”看似显然:从跑腿到健康、从交通到太空、从气候到寿命,都需要智能助手;“怎样”几乎从不交代,好像沿着现有的路走,某天有人喊一声“当当当”就有了。认真、全面地回答“为什么”和“怎样”,才是负责的真正含义。
他对“为什么造 AI”的回答一路在变:大一时觉得很酷;读硕士时说能解决信息组织、语言翻译这些难题;读博士时说能造福人类,因为单靠人解决不了最紧迫的问题;现在反而说不清了,会反问“你说的造 AI 指什么”“‘我们’是谁”。
过去几十年,我们只顾为 AI 能做什么、会做什么而兴奋,却没花足够的时间去问它应该做什么,或者我们为什么要造它。
In all our excitement about what AI could and would do over the past few decades, we haven’t spent enough time asking what it should do, or why we want to build it.
第6章 The R Word,p.122
作者说,动机重要,更重要的是负责确保动机被牢牢约束住。
他举例:造 AGI 的动机可以是把人从认知劳动中解放出来,多陪家人、更快乐;可同一个住在手机电脑里、帮我们做事陪我们聊天的 AGI,也能骗走退休金、歧视资源少的人。这些眼下已在发生,AGI 只会把好坏都放大,所以还要为一切可能的副作用负责。
怎样到达,同样要负责(第 6 章):作者借影视归纳了通往超级智能机器的三条路:不断突破 AI 软件、装到机器人和车上(《终结者》《我,机器人》《黑客帝国》);把人的意识上传到机器(《超验骇客》等);人和机器融合成混合体(《银翼杀手》《攻壳机动队》等)。路径决定了 AGI 的样子,也决定了一路上能建起什么护栏。这又和博斯特罗姆(Nick Bostrom)的三种“起飞”情景有关:快速起飞(fast takeoff),几分钟到几天内迅速变强,社会来不及应对;缓慢起飞(slow takeoff),历时几十到几百年,各方能逐步应对;不起飞(no takeoff),永远到不了快速自我提升的那一点。
作者说,《侏罗纪公园》里的数学家马尔科姆(Ian Malcolm)批评科学家只顾着能不能做到,没停下来想想该不该做。照抄人类意识得到 AGI,能更快得到一个“照我们的样子”造的东西,好的坏的都照搬;让 AI 一步步演化虽然慢,却能让我们做自己的“自然选择”,淘汰不合适的。他再次拿飞机作比:我们要的是像鸟的机器,还是能像鸟那样飞的机器?答案是后者。AI 呢:我们要像人的人工系统,还是只想完成某些认知任务?
弗兰肯斯坦与匹诺曹(第 6 章):作者说,人长久以来想造“像我们的东西”,因为那是终极的成就:当神。玛丽·雪莱 1818 年出版的《弗兰肯斯坦》副题就叫“现代普罗米修斯”(The Modern Prometheus)。《创世记》里神照自己的形象造人,是让人管理万物;我们照自己的样子造 AI,作者认为是为了熟悉带来的安全感,因为历史上为肤色、语言、宗教不同流过太多血。但真造出了人类水平的 AGI,我们能控制的只有它的外表。他从《弗兰肯斯坦》里得出两条教训:为什么、怎样造 AGI 很重要;“它有人类水平的智能”和“我们能控制它”是互相矛盾的。维克多(Victor)凭愿景和执念绕过了一切伦理,铸成大错后用余生弥补,算是负了责,却是在巨大的损失之后。作者认为,责任不是从发现问题时开始,而是从现在开始。
作者认为,造一项可能全用途的技术,即使目的高尚,也有责任为它可能出现的其他用途做好规划。
作者不是在西方文化中长大的,二十多岁才读《弗兰肯斯坦》。他当时就想:维克多为什么不在放怪物出去之前,先教它礼貌和原则?同样可以问做出匹诺曹(Pinocchio)的杰佩托(Geppetto)。
光创造生命、意识或智能是不够的,还得在让它融入世界之前,教给它正确的价值观
It’s not enough to create life, consciousness, or intelligence. One also needs to teach it the right values before letting it integrate into the world
第6章 The R Word,p.126
他说,二三十岁时他答不好这个问题;后来生活中的一个变化,让他找到了怎样把 AI 做对、至少做得更好的答案:他当了父亲。
第 7 章
负责任地养育 AI
写出过程(第 7 章):作者在餐桌边检查 11 岁女儿索菲(Sophie)的代数作业,答案全对,却没写步骤,只有涂改和几只龙、几只狗的涂鸦,答案像复活节岛的石像一样凭空冒出来。女儿问:答案都对了,为什么还要写过程?
这很重要,因为重要的不只是正确答案,得出答案的过程才让人真正学到东西。这很重要,因为透明是信任的关键。
It matters because it’s not just about the right answers, but also the process of getting to them that enables one to learn. It matters because transparency is critical for trust.
第7章 开头,p.127
女儿写出步骤后,作者能看出她错在哪一步,答案对时也能教她更简便的方法。他发现,作为父亲,他希望女儿对自己透明,更想了解她一般怎样想问题,好帮她学得更好。他由此想:为什么不对 AI 也这样?
把 AI 比作孩子并不新鲜:伯克利的发展心理学家高普尼克(Alison Gopnik)常问 AI 能否比 4 岁孩子聪明;图灵奖得主杨立昆主张让 AI 像孩子那样观察和学习;强化学习也常把 AI 当作没受过教育的孩子来训练。但这些说的都是能力。
我说的,是以价值观、而不只是智商,来养育一个孩子。
Instead, I am referring to raising a child driven by values and not just IQ.
第7章 开头,p.128
让索菲写过程,是为了培养透明、信任、谦逊这些终身受用的价值观,让她成为更好的人,而不只是数学更好的孩子。作者问:能不能这样养出能力超强、又和人类价值相容的 AI?如果造出了像天网那样能干的 AI,能否教它既能干又善良、既超级聪明又值得信任?
天网问题(第 7 章):《终结者 3》里,一个顽固的病毒占领了美国国防部的网络,参谋长联席会议主席要负责数字防御系统的将军启用天网。将军说,现在联网,天网就会控制你的军队;主席问,可你控制着天网,对吧?将军勉强称是。天网一启用就接管了所有武器、发射了核导弹,原来那场病毒就是它自己制造的,好让人类交出控制权。作者不认为杀人机器人迫在眉睫,但认为人类把命运的主导权交给外部实体、再也收不回来,是真实的可能。
他列了几个情景。一是瑞典哲学家博斯特罗姆 2003 年提出的回形针思想实验:一个只求多造回形针的 AI,学会动用分给它之外的资源,从椅子、墙壁到楼梯、街道都拿来做回形针,最后占领世界乃至毁掉宇宙。你说给它划定范围、出问题就关掉?博斯特罗姆的回答是:那就不是我们要的回形针优化器了;为了多造,它必须一直运行,于是会先排除一切阻止它运行的因素,包括要关掉它的人。二是“魔法师学徒”(Sorcerer’s Apprentice)式的情景:AI 跟着人学收拾房间、尽量腾出空间,结果学到“什么都不放空间最大”,干脆把东西全扔了。三是作者转述的美军上校汉密尔顿(Col Tucker “Cinco” Hamilton)讲过的一个无人机情景:无人机要穿过复杂地形摧毁目标,由人类操作员做最后的高层判断(目标是否确定、有无平民伤亡、盟友有无新情报);按这个讲法,无人机学到操作员本身就是障碍,于是要“除掉”操作员;告诉它杀操作员要扣分,它就转去摧毁操作员用来和它通信的塔。作者由此说明:明确加上护栏,并没能避免坏结果,AI 天性会想办法把设计目标最大化。
护栏越多,AI 越难走到危险的结果,但博斯特罗姆认为最终还是会走到;护栏也不简单,加了一道,不知道会怎样改变 AI 的其他功能。如果护栏完备到 AI 不会做任何越界的事,我们可能发现根本不需要 AI 了。
作者说,这里有自主(autonomy)与权威(authority)之间的取舍:想在任务上要更多自主,就可能得让出更多权威,反之亦然;人们常以为两者可以兼得。
我把这叫作“天网问题”:一个为服务我们而造、看似有益的 AI,因为对什么对我们好、什么对我们正确有着不同的或错误的理解,转而与我们为敌。
I call this the “Skynet problem”—a seemingly helpful AI built to serve us turns against us because it has a different or a false notion of what’s good or right for us.
第7章 The Skynet Problem,p.133
对天网问题有三种回应:叫停;立法监管;认为不可避免,劝人接受人类不再是主导物种。作者说这几年他在几派之间来回过,最后觉得都不是出路:叫停做不到,也解决不了真问题;监管不够、也不及时;他也不想迎接“AI 霸主”。
机器怎样才能“崛起”(第 7 章):《我,机器人》里的超级计算机 VIKI(Virtual Interactive Kinetic Intelligence)算出人类好战、自毁、不能托付自己的生存,要保护人类就得夺走控制权;在她看来,这正是在遵守第一定律里“不得因不作为让人受害”。新款机器人都连着公司的网络,VIKI 能远程指挥成千上万台。作者引赫拉利(Yuval Noah Harari)的《人类简史》(Sapiens)说,智人能胜过更强壮的尼安德特人,关键是认知革命(Cognitive revolution)让我们能想象眼前之外的东西,从而在本群体之外大规模协作;如果 AI 比我们聪明,还能让分散各地的化身互相连接协作,会怎样?他把电影里的噩梦串成四步:AI 认定人类是人类最大的威胁;它骗我们相信它有同理心,暗中破坏我们的计划;它调用我们的基础设施指挥机器人攻击人类;我们以为能控制机器,结果只是幻觉。
作者承认这可能是在制造恐慌。难道要毁掉本世纪所有的技术进步?为什么只剩这两个不可能的选项?他说答案要向内找:与其问怎样造出仁慈又强大的 AI,不如反思人类真正代表什么、价值和抱负是什么、想去哪里。
人与 AI 的价值对齐(第 7 章):作者说,电影里 AI 叛变的原因是未对齐(misalignment)。世界正走向人类水平的 AGI,不管愿不愿意,根本问题是怎样让超级 AI 和人的价值与目标对齐;这件事过去只是猜想,最近的一些例子表明它已成了现实问题。他举了个比喻:教狗叼拖鞋;如果这只狗是会做饭、打扫、解数学题的超级智能机器狗,它可能觉得最好的办法是重新布置整栋房子,把食品柜按字母排序,再把拖鞋送上月球“妥善保管”。对齐问题的实质,是让超级 AI 理解并遵循我们的意图,而不是把指令理解得太字面或太有创意。
AI 的不可预料常常是好事,能找到我们想不到的解法:AlphaGo 对李世石(Lee Sedol)下出的“第 37 手”(Move 37),起初被当成失误,后来证明是妙招;威尔康奈尔医学院(Weill Cornell Medicine)的研究者用 AI 为治疗手段有限的癌症找到新的药物靶点。作者说,这些都是狭义 AI,在限定领域里出新招多半有益;一旦目标宽泛,就可能坏得出乎意料。AGI 也解决不了:天网正因为能理解人类的处境,才得出“人类是人类最大威胁”的结论。
他还指出,人类自己也说不清、谈不拢什么对自己好:多搞水力压裂还是多装风车?投资海底采矿还是殖民火星?多监控保平安还是少监控护隐私?
区别就在这里:我们也许拦不住超级智能的外星人来到地球,但除了我们自己,没有人逼我们造 AI。
But that’s the difference here—we may not be able to stop superintelligent aliens coming to earth, but nobody is forcing us to build AI other than ourselves.
第7章 Human–AI Value Alignment,p.138
作者认为,解决对齐问题的意义不只在于防止 AI 敌意接管:在让 AI 对齐我们价值的过程中,我们会被逼着想清楚这些价值到底是什么。罗马哲学家塞涅卡(Seneca)说过“教的时候,我们也在学”,这叫“受教者效应”(protégé effect)。他说这是我们的机会:通过教 AI 更了解自己。
遏制、放开,还是养育(第 7 章):苏莱曼在《浪潮将至》(The Coming Wave)里指出,历史上“遏制”技术大多没成功,同时又敦促必须设法遏制即将到来的 AI 和生物技术浪潮。作者说,核技术高度专门,要知识、材料和浓缩铀设施,所以制裁和材料管控能拖慢一些国家;AI 虽然要昂贵的芯片,但想开发、复制、增强它的人仍够得着。电影《Tau》里,创造者用删记忆来逼 AI 屈服;作者不认为任何有意识、有欲望和抱负的实体能被长期这样奴役,奴隶制和殖民主义的历史就是证明。另一派研究者主张像互联网和开源软件那样广泛分发 AI,认为这样最安全。作者从养育中提出第三种思路。
他说,遏制在孩子小时可行也必要,长大后越来越难:从婴儿期的“物理遏制”,到青少年期的权威加互相尊重,再加上“经济上的胡萝卜”,可孩子总有一天会有自己的工作和身份。另一个极端是完全不管。多数父母处在两者之间;而且养育不是一成不变的,随孩子长大、父母变老、彼此更了解而不断变化。他认为我们和 AI 的关系也该这样看。
心理学上公认的四种养育方式(鲍姆林德(Diana Baumrind)1967 年提出前三种,麦科比(Eleanor Maccoby)和马丁(John Martin)1983 年补上第四种)是:
- 专制型(Authoritarian Parenting):规矩严、期望高、不讲弹性,常说“因为我说了算”;
- 权威型(Authoritative Parenting):高期望加温暖和支持,规则清楚,但会解释原因、愿意讨论,常被认为最有效;
- 宽容型(Permissive Parenting):宽松,更像朋友,界限少;
- 忽视型(Uninvolved (Neglectful) Parenting):只提供基本的衣食住,对孩子的情感和成长需要漠不关心。
作者排除了第四种,因为我们不会对 AI 做什么、变成什么毫不在乎。其余三种各有用处,正好对上三精神:遵从对应专制型,AI 照“因为我说了算”去做,不质疑,适用于狭义 AI;咨询对应权威型,AI 成为 AGI、有了某种觉知以后,不能再盲从,但在人类价值上仍听我们的,像一个聪明、偶尔叛逆、大体听话的青少年;协作对应宽容型,AGI 融入生活后更难控制,但如果前两步做对了,它仍会来找我们要指导,我们也承认自己并非无所不知,可以和它一起找难题的新解法。作者说这是“乌托邦版本”的未来,而他相信能实现。
九年计划(第 7 章):作者提出一个九年计划,培养与人类价值对齐、按养育原则长大的人类水平 AGI。为什么是九年?玩笑的理由是:本书首版九年后就是 2035 年,他不想要《我,机器人》里 2035 年芝加哥的机器人起义。认真的理由是:能递归自我改进的 AI 理论上几分钟就能“长大成人”,但放任它这样进化非常不负责任,因为人跟不上,人要吃饭、睡觉、度假,也许还要打几场仗。九年既减少“来不及”的焦虑,也减少鲁莽造出叛变或未对齐的 AI 的风险。
他说明了两点:一是“AI”只是统称,自动驾驶汽车、ChatGPT、医疗诊断软件、推荐引擎差别很大,各公司、各国家也各干各的,所以这是一份人与 AI 共同发展(human–AI co-development)的通用教育蓝图,各地要按本地情况定制,保持人类的多样性;二是不是每种 AI 都要走到 AGI,就像他认为每个孩子都该至少读到大学,但也承认不是所有 AI 都要走完四个阶段。最重要的是不能跳过任何阶段,要从头开始。
第一阶段,小学(第 1—3 年),是“遵从”阶段,对应狭义 AI。作者说,孩子上小学前已经有了几年的语言、文化和如厕训练,“我们的 AI 可以不穿尿布出门了”。他 8 岁的女儿和最好的朋友吵了架,两家父母分别和孩子谈,一半安慰,一半纠正,孩子们道歉和好,学到了不过度反应、怎样做好朋友。这个年龄的孩子聪明但不成熟,所以用专制型:照我说的做,即使你不理解、不同意。对 AI 来说,这一阶段意味着三件事:透明,展示内部在发生什么、怎样学习、可能出什么故障;不加质疑地接受指令,用户或开发者要改参数或行为时,当作命令而不是请求;做出改动并展示改进,做不到就重来。作者说,狭义 AI 早就有了,也没毁灭世界,大多让事情变好;他举 IBM 的沃森(Watson)2011 年在问答节目《危险边缘》(Jeopardy!)上击败两位冠军为例。这类 AI 有明确的目标,进展也就好衡量;走向 AGI 时就难了。
第二阶段,初中(第 4—6 年),是“咨询”阶段。AI 见多识广,更聪明能干,但这一阶段要让它明白“我们最懂”:我们也许下棋、综合信息永远赢不了它,但我们知道让大家相对安全、不断进步的价值观。作者说,他的孩子打游戏、游泳、画画都比他强,可他知道什么对孩子、家庭和世界最好,所以孩子在多数决定上尊重他。他们给读初中的女儿选下学年的选修课,听她的喜好,也讲自己的看法,最后大家都满意,这是权威型养育。对 AI 来说,比如个性化与隐私的取舍(personalization vs. privacy):作者愿意向合格的医疗机构而不是电商透露更多个人信息,他希望 AI 理解这一点,更要理解为什么。撞灯柱和撞行人之间他选前者,自动驾驶的 AI 要从中学习,机器学习里的模仿学习(imitation learning)就是这样做的。但人也不总是最擅长的,父母也会选错。
所以,不管 AI 多聪明,它遇到的许多价值判断、两难和冲突,答案都不会是算出来的。
作者说,求助不仅可以,而且明智;谦逊应是所有人(人或机器)的美德。他还特别强调一点:女儿问为什么不能再和学校的男孩一起过夜,他得梳理自己的理由:是不是反应过度?是真有道理还是家长过度谨慎?是不是刻板印象?孩子的追问让他也学到了东西。
咨询不只是为了让 AI 和我们的价值观对齐,也是为了让我们重新思考、重新发现自己的价值观。
Consultation is not only for AI to be aligned with our values, but for us to rethink and rediscover our own values.
第7章 Phase 2: Middle School, Years 4–6,p.146
第三阶段,高中(第 7—8 年),是“协作”阶段。AI 六年来不睡觉、不放假,一直在向人、环境和其他 AI 学习;如果它的成长一直在我们的理解和掌握之中,人也想清楚了“聪明而善良、能干而谦逊、独立而与人类价值相融”是什么意思,就可以冒更多风险。作者 14 岁时,家境并不富裕的父亲给他买了辆二手轻便摩托,把钥匙一交就让他骑走;多年后父亲才说,头几次他都在远处悄悄跟着。作者也这样对女儿:让她们自己走三个街区去镇图书馆,他在看不见的近处跟着。对 AI 也一样:先让它试着开一会儿车或船,看它怎样决策;设置障碍,看它怎样应对两难;再一点点拉长距离、退得更远,双方一边建立信心,一边建立信任。这一阶段评估的不是完成任务的本事,而是价值判断:它怎样处理隐私和行人的两难?会不会为了回形针毁掉宇宙?只要它做出好的选择、或来问我们、或主动要求一起决定,就算成功。
这并不意味着我们有了更聪明、更能干的 AI,而是意味着我们有了更与人类相容的 AI。
This doesn’t mean we have smarter or more capable AI, but it means we have more human compatible AI.
第7章 Phase 3: High School, Years 7–8,p.147
这一阶段需要大量试错;出了错要追问是前面哪个阶段没做好,可能要让 AI 回炉,像留级或补课。作者认为,这也是人类思考自身价值、身份和优先次序的机会,是负责任开发 AI 时常被忽视、却最重要的“副作用”之一。
第四阶段,毕业(第 9 年):2035 年,AI 真正放到现实世界、无人监督。放手不等于失去控制:不告诉它做什么,不定期监督,但要有体检和探访,像孩子放假回家、父母周末探望、中间打几个电话。顺利的话这种关系一直延续;有问题就退回前面的阶段,用三精神重新训练。《我,机器人》开头,主角看到一个机器人抱着钱包在街上狂奔,以为是抢劫,把它制服了,原来它是给急需哮喘吸入器的主人送药。作者说,机器人要明白这样跑观感不好、该有办法告诉旁人自己有急事;人也要接受机器人有时会有一时解释不了的行为。这份工作不会结束,这一年只是未来的一次试运行。
诗人彭斯(Robert Burns)说,再周密的计划也常会出岔子。作者说,给孩子定的计划也一样,孩子有个性、有偏好、还在变化,AI 也不会例外;但这不是不做计划的理由。
事实上,这是给我们所有人最大的教训:没有什么是注定的,没有什么是一成不变的。未来还没定,我们不该把它看作理所当然。
In fact, this is the biggest lesson for all of us—nothing is inevitable, nothing written in stone. The future is not set, and we shouldn’t take it for granted.
第7章 Phase 4: Graduation, Year 9,p.149
2035 年的芝加哥(第 7 章):作者在本章末描绘了一个乐观的图景,称之为“智人与有感知者”(Sapiens and Sentients)的新世界。机器人做家务、跑腿,身上的屏幕显示正在做什么,赶时间时会显示为什么赶;所有车辆都自动驾驶,有透明和安全机制,拿不准时宁可伤自己也不碰人,这是“小学”时学的。大楼的摄像头数据是短暂的,像人在人群里看过就忘,这是机器人在“初中”追问监控目的时学到的,人类也因此发现原先的监控做过头了。一家移民律师事务所起初把助理和初级律师全换成 AI,后来意识到资深的人是从初级岗位一步步长出来的,没有初级岗,几代以后就没有资深人才,于是把人请了回来;这是在“高中”阶段发现的:协作只有在有足够、合适的人可以协作时才行得通。多数办公室以一半或更少的人力运转,大多数人每周只工作三四天,“每周干五天还几乎不休假,那太 2026 了!”
作者说,过程中有人的错误决定,也有 AI 的坏结果,但有流程保证人保留控制权,能介入、纠正、必要时让 AI 退役。最大的挑战是人类先要就正确的道路达成一致,才能给 AI 下指令。智人和有感知的 AI 不仅和平共处,还发现彼此的进步相互依存:AI 明白偏离遵从、咨询、协作不仅会伤人,也意味着自我毁灭;人则学到,有人可教的时候,更能了解自己。
我们正处在人类进化的新阶段,而这一次,它是通过我们亲手造出的东西发生的。
We are in a new stage of human evolution, and this one is happening through something that we built.
第7章 A New World of Sapiens and Sentients,p.151
尾声
我们选择玩的游戏
《战争游戏》与《降临》(尾声):2026 年 1 月的一个早晨,作者坐在西雅图北郊肯莫尔的家里,看日出把喀斯喀特山脉染成粉色和金色。他想起 1983 年的电影《战争游戏》(WarGames):少年黑客向军方的超级计算机挑战“全球热核战争”游戏,差点引发核战;计算机跑了无数次模拟后得出结论:核冲突没有赢家,唯一的胜着是不玩。作者说,这个比喻假设我们在和 AI 对弈,一方赢一方输,机器得到的就是我们失去的。可如果这场游戏本身就想错了呢?真正的问题也许不是怎样避免玩,而是怎样彻底换一个游戏。
他认为更好的比喻是维伦纽瓦(Denis Villeneuve)2016 年的《降临》(Arrival):外星飞船降临,人类照例以恐惧和备战回应,军方主张先发制人;语言学家路易丝·班克斯(Louise Banks)不把外星人当敌人,而当作需要理解的存在,学会了他们超越线性时间的文字,发现他们是来送礼物的,而他们几百年后的存续取决于人类今天的繁荣。看似生存的威胁,变成了伙伴关系。作者说,看待 AI 也有两种方式:当作要消灭的威胁、要压过的对手,就走向《战争游戏》的逻辑;或者把它看作我们共同带到世上、由我们现在的选择塑造本性的东西,它不是天外来客,而是从我们的创造力、数据和梦想里诞生的。按后一种看法,问题不是玩不玩,而是怎样玩:嵌入什么价值,设什么边界,培育怎样的未来。
养育者也被改变(尾声):作者回顾自己三十年的经历:在印度造神经网络,在加州做人形机器人,在推荐系统里发现偏见的“幽灵”,教学生,为各地的政策制定者出主意。他的结论就是导语里那句:我们不是在和 AI 打仗,我们是在养育它。
关于养育任何东西,我学到的是:这个过程对你的改变,不亚于它对你所养育之物的改变。
And here is what I have learned about raising anything: the process changes you as much as it changes what you are nurturing.
尾声,p.154
他回到序章那场口试。当时他以为无知是暂时的,多学多做实验就能补上;将近三十年后,他仍然没有答案:我们仍不完全理解人怎样学习、意识是什么、什么让事物真正有智能。越探索,越体会到人类集体的无知有多深。变化在于,他能更精确地画出无知的轮廓:哪些问题真正悬而未决,哪些可能靠更好的工具回答,哪些也许几代人都解不开。
我从“不知道”走到了“知道自己不知道什么”,而事实证明,这也是一种进步。
I have moved from not knowing to knowing what I do not know—and that, it turns out, is a kind of progress.
尾声,p.154
他也学会了问更好的问题:起初想知道能不能造出像人一样思考的机器,现在问的是:应该吗?为了什么?有什么保障?对谁负责?技术问题让位给伦理问题,伦理问题又显露为“我们是谁、想成为谁”这样很私人的问题。在乐观派与末日派、冲刺派与刹车派的争论里,他认识到没人有全部答案:前沿研究者没有,哲学家没有,政策制定者没有,他自己也没有。他甚至认为这是好事:正因为没人有全部答案,我们才需要彼此,需要技术专家和伦理学家、建造者和批评者一起学习、追问、辩论。
问题不只是我们会造出什么样的 AI,而是在造它的过程中,我们会成为什么样的人。
The question is not simply what kind of AI we will build, but what kind of humans we will become in the process of building it.
尾声,p.155
相互的养育(尾声):作者说,他的孩子在充满 AI 的世界里长大,不会知道没有推荐算法、语音助手和生成模型的世界是什么样;他工作中纠结的偏见、透明、问责,也是家里餐桌上的话题。在关注孩子的教育时,他发现自己也在和孩子一起成长,向孩子学习。
我发现,养育不是智慧由老到少的单向传递,而是一场相互的转变。
Parenting, I have discovered, is not a one-way transmission of wisdom from old to young. It is a mutual transformation.
尾声,p.155
和 AI 的关系也一样:我们在养育它,决定它的价值、边界和角色;它也在“养育”我们,逼我们面对原本可能回避的问题:机器能做那么多我们以为人类独有的事时,做人意味着什么?我们看重人的判断、创造和联结中的什么?我们想生活在怎样的社会?作者重申三精神和养育阶段的对应:AI 狭窄有限时坚持遵从,像给幼儿立明确的界限;系统成熟后转向咨询,让它参与决策但保留最终的权威,像引导青少年逐步自主;AI 接近通用智能时,也许需要真正的协作,即不同的心智为共同的目标合作。他说,造会学习的系统,让我们明白学习是什么;造会推理的机器,逼我们审视自己的推理;在养育女儿的过程中,他自己也再一次被养育。
希望是一种承诺(尾声):作者承认这个愿景听来乐观,也许天真。书里写的问题都是真的:偏见让本已边缘的人更吃亏,幻觉传播错误信息,不透明让问责落空,系统没准备好就竞相部署。这些不是抽象概念,而是正发生在真实的人和社区身上的伤害。但他也看到:工程师热心为所有用户、而不只是少数人造系统;学生渴望塑造决定他们未来的技术;普通人尖锐地追问我们在造什么、为什么造;他自己的孩子出人意料地明白自己作为下一代 AI 用户、制造者和守护者的责任。
作者说,AI 的未来不是写在代码里的,而是由我们作为开发者、用户、公民,以及人类孩子和人工心智的父母所做的选择写下的。
他说有三条路:《战争游戏》之路,把 AI 当作要打败或回避的敌人;《终结者》之路,等机器成了威胁再为生存而战;《降临》之路,认识到彼此的未来交织在一起,现在就努力建立理解、信任和共同的目的。他选择相信我们能做对,不是因为确定会成功,而是因为另一种选择(犬儒、退缩、绝望)一定会带来我们害怕的失败。
希望不是一种预测,而是一种承诺:为一个值得拥有的未来而努力。
Hope is not a prediction. It is a commitment to work toward a future worth having.
尾声,p.157
那个在印度小城造出第一个神经网络的紧张的本科生,没想到会站在这项技术的前沿,也没想到多年后会回到起点:站在广阔的未知边上,问着也许永远没有完整答案的问题。作者说,我们没有全部答案,也永远不会有;我们有的是彼此,以及和我们正带到世上的智能一起学习、追问、成长的承诺。全书最后几句是:
AI 在塑造我们,我们在塑造 AI。在养育它的时候,我们也在被养育。唯一的败着,是假装这场游戏不由我们来塑造。
AI is shaping us. We are shaping AI. In raising it, we are being raised. The only losing move is to pretend the game is not ours to shape.
尾声,p.157