《人工智能简史》
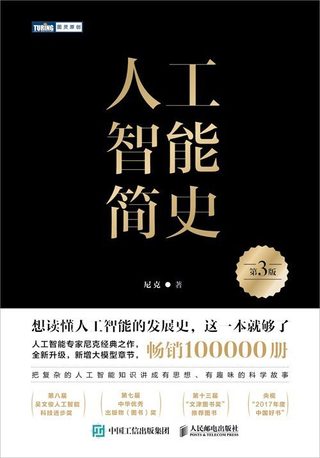
- 出版时间
- 2026年4月
- 版次
- 第3版
- 页数
- 404页
- 装帧
- 平装
- 字数
- 268千字
- ISBN
- 9787115694676
我的读书笔记 · BOOK OVERVIEW
从达特茅斯到 DeepSeek,一部人物和门派的 AI 江湖史
作者尼克曾师从图灵奖得主、强化学习的奠基人安德鲁·巴托,和书中许多人物是师友或熟人。这本书 2017 年底初版,成了畅销书;2026 年出第 3 版,主要因为大语言模型,新增了两章讲大语言模型的历史和理论,一章从教科书看学科变迁。
人工智能的三派
- 逻辑主义像理性主义规则派:从定理证明到知识图谱
- 连接主义像经验主义统计派:从神经网络到深度学习
- 自然主义像实用主义从细胞自动机到强化学习
第 16 章。作者认为三派正在融合。
作者说,历史有以人为主和以事为主两种写法,他偏向以人为本,八卦与考证并重(第 1 版前言)。所以这本书读起来不像教科书,而像一部人物和门派的江湖史:达特茅斯会议上谁抢了谁的风头,谁和谁结了梁子,谁的学生接了谁的班。作者的评论也很鲜明,常常“夹枪带棒”,他自己猜这是书畅销的原因之一(第 2 版前言)。
书的主线有两条。一条是派别:从图灵起,人工智能就分成“想啥来啥”的符号派和“吃啥补啥”的神经网络派,后来又有向自然学习的一支。另一条是作者反复强调的“第一性原理”:计算理论。他认为人工智能缺的正是这个,并在新版里提出,所罗门诺夫 20 世纪 60 年代的归纳理论就是大语言模型的数学基础。
语言是人工智能的终极(ultimate)课题之一,但针对语言的工程的历史并不长。
第3版前言
前言
怎么写人工智能的历史
以人为本,八卦和考证并重(第 1 版前言):第 1 版由作者的几篇博客和报刊文章扩充而成,史料包括巴贝奇研究所近 100 小时的口述历史录音,还用谷歌 Ngram 统计词频来看学科的兴衰。作者说,有一种科普是“用一些貌似通俗的语言去解释复杂的原理”,他一直不大相信,更喜欢讲历史和八卦的书:
读大科学家写的科普著作,最有意思的倒不是那些对成熟思想的通俗叙述,而是那些对不成熟看法的披露,还有不好意思写到正经学术论文里的自负和牢骚。
第1版前言
什么是人工智能(第 1 版前言):人工智能没有公认的定义,作者用一个外延式的说法:
从实用主义(哲学的“实用主义”,不是日常用语“实用主义”)看,一个学科就是学科共同体共同关注的东西。
第1版前言
为什么破例写当代史(第 3 版前言):作者说,历史本不该写正在发生的事,当代史应该交给新闻记者,可是大语言模型发展太快,只好破例。
时间颗粒度缩小,每一年都会是一个新纪元。
第3版前言
他在第 3 版前言里已经亮出几个后文要展开的判断:所罗门诺夫的归纳理论可以作为大语言模型的“第一性原理”;“世界模型”是没赶上大语言模型浪潮的人的说辞;具身智能的难题在工程而不在原理。
但请别忘了,世界模型离不开基座语言模型,无论你建的世界模型是哪个世界的。
第3版前言
第 1 章
达特茅斯会议:门户之争从一开始就有
两条路(第 1 章):1956 年达特茅斯会议之前,1955 年的一次学习机讨论会上,塞弗里奇(Oliver Selfridge)讲模式识别,纽厄尔(Allen Newell)讲计算机下棋。主持人皮茨(Walter Pitts)总结说,一派人试图模拟神经系统,纽厄尔试图模拟心智,“殊途同归”。作者认为这预示了此后几十年逻辑和神经网络两条路线的矛盾。
发起人和“搅局者”(第 1 章):会议由麦卡锡(John McCarthy)和明斯基(Marvin Minsky)发起,本意是创立新学科,却被带来“逻辑理论家”程序的纽厄尔和司马贺(Herbert Simon)抢了风头。作者说麦卡锡视这两人为外人、搅局者,门户之见后来演化成学派之争。纽厄尔和司马贺代表符号派,提出“物理符号系统假说”:智能就是对符号的操作。
当事人的回忆不可尽信(第 1 章):作者的史学方法是多方比对。他说当事人都在世时不方便互相揭短,到了晚年或对头已死,“一不留神就会流露真话”。
研究历史有时得全方位,空间或时间上的接近不见得就真实。
第1章 4.会议之后
“人工智能”这个名字(第 1 章):作者说,这个词真正被广泛接受,是在哲学家德雷弗斯(Hubert Dreyfus)1965 年发表批评文章《炼金术与人工智能》之后。
有时一个共同体的形成并不是靠内部的团结,而是靠外部的反对。
第1章 3.AI历史的方法论
像哲学一样的学科(第 1 章):麦卡锡首创了分时系统,作者认为这比他在人工智能上的贡献更显著。由此他打了个比方:
从这个意义上说,AI有点像哲学:由AI衍生出很多问题,而对这些问题的解决产生了许多子学科;一旦这些子学科独立,就不再待见AI了。
第1章 4.会议之后
过度推销(第 1 章):司马贺 1957 年预言 10 年内计算机下棋会胜过人,明斯基 1968 年说 30 年内机器智能可与人一拼。明斯基后来自己解释:
一门年轻的学科,一开始都需要一点“过度推销”(excessive salesmanship)。但是过头了不免被人当作狗皮膏或炼金术。
第1章 5.预测未来:会有奇点吗?
悟性在哪里(第 1 章):卡斯帕罗夫 1995 年还批评计算机缺乏悟性,1996 年就觉得“深蓝”好像有悟性了,而这期间“深蓝”的算力只提高了一倍。作者的看法是:
机器有没有悟性的边界其实就是人的解释能力的极限。量变到质变的临界点就是人的解释能力,人解释不了的东西就有悟性,解释得了的东西就没有悟性。
第1章 5.预测未来:会有奇点吗?
资助的品位(第 1 章):作者对比了两种资助:美国国家科学基金会用同行评议,越有成就的拿钱越多,却很少有根本性原创;ARPA 早期由主管说了算,主管品位好就能支持好东西。他问:
大型项目决策者的品位可以超越“透明计算”吗?
第1章 4.会议之后
第 2 章
定理证明:符号派的源头
源头(第 2 章):作者认为,专家系统、知识表示、知识图谱,追到底都是机器定理证明的改头换面:
人工智能中符号派的思想源头和理论基础就是定理证明,不懂定理证明就没法深入了解符号派。
第2章 1.自动定理证明的起源
第一个能运行的定理证明程序不是“逻辑理论家”,而是戴维斯(Martin Davis)1954 年写的。王浩(Hao Wang)1958—1959 年写出高效得多的程序,对“逻辑理论家”很不屑,留下一句名言:
杀鸡焉用宰牛刀,但他们(指纽厄尔和司马贺)拿着宰牛刀也没能把鸡杀了
第2章 1.自动定理证明的起源
作者认为,王浩的研究启发了学生库克(Stephen Arthur Cook)的 NP 完全性理论,“孕育了整个理论计算机科学”。
冤冤相报(第 2 章):符号派内部又分“逻辑派”和“心理派”。王浩当年讥讽了心理派的纽厄尔和司马贺,后来费根鲍姆(Edward Albert Feigenbaum)猛烈批评做归结原理的逻辑学家罗宾逊(Alan Robinson),作者认为这是替老师报一箭之仇。两派互相攻击,是这个领域凋零的人事原因。
吴文俊和王浩(第 2 章):吴文俊研究中国数学史时受到启发,为一大类初等几何问题给出了高效的机器证明算法。作者认为,在为人类文明做出突出贡献的中国人名单里,“还应该有王浩和吴文俊”。
比黑盒子更黑(第 2 章):1976 年四色定理借助计算机证明,哲学家追问“四色定理算被证明了吗?”;2016 年一个数学问题的证明有 200TB。作者说,数学共同体的实践标准在变:“从数学家之间互相核实到数学家信任的程序之间互相核实”。
我们原本以为定理证明是最可解释的,因为每一步都有严谨的逻辑推理,但当我们面临一个有几百TB的证明时,这恐怕比深度学习都更难解释,比深度学习学出来的黑盒子更黑。
第2章 8.哲学问题
有些领域,一开始就把百分之八十的容易问题解决了,而后就一直很难,进展很慢,少有突破。人工智能就是这样,定理证明尤其如此。
第2章 9.基于逻辑的定理证明的没落
起死回生之势(第 2 章):作者说,不讨厌人工智能的数学家从大语言模型的成功中学到了教训,证明助手 Lean 就是例子,定理证明“大有起死回生之势”。
人工智能是人脑的增强或替代,不可解释性是必然的。
第2章 11.结语
第 3 章
从专家系统到知识图谱
新瓶装旧酒(第 3 章):从第一个专家系统 DENDRAL、医疗诊断的 MYCIN,到 DEC 公司为订单自动配置零件的 XCON,专家系统在 20 世纪 80 年代红火了十年。作者认为它的底子仍是定理证明:
如果从纯粹的定理证明的角度简单地看专家系统,所谓知识其实就是公理,公理越多,推理的步骤自然就会越少。
第3章 7.谷歌和知识图谱
一个领域成熟与否的主要测度之一是赚不赚钱。
第3章 3.专家系统的成熟
自动脱离(第 3 章):明斯基提出的“框架”催生了面向对象的程序设计。作者说:
从这个意义上还真验证了:当一个概念有了成熟的实现时,就自动脱离了人工智能。
第3章 4.知识表示
Cyc 和语义网(第 3 章):雷纳特(Douglas Lenat)从 1984 年起要把人类常识一条条录入 Cyc 知识库,宣称“智能就是一千万条规则”。作者的结论是:
现在已经过去了30多年,我们还是看不到Cyc的可观应用。
第3章 5.雷纳特和大知识系统
对伯纳斯-李(Tim Berners-Lee)提出的语义网,作者的评价是“理论上不严谨,实践中不可用”的大杂烩:
所谓“万事开头难”,但开了一个坏头,则是灾难,为后人修正制造了人为障碍。
第3章 6.语义网
走向融合(第 3 章):大语言模型最有效的训练数据来自维基百科这类知识图谱,知识图谱也开始用图神经网络做补全。
逻辑派的知识图谱和经验派的神经网络正在走向融合。
第3章 8.知识图谱与深度学习
第 4 章
日本第五代计算机的教训
无人区的赌博(第 4 章):1978—1994 年,日本押注逻辑程序设计语言 Prolog,想造“第五代计算机”。作者认为,此前日本通产省资助的项目都是赶超型的,从没失手;五代机是真正的创新:
赶超是“有人地”,结果相对可预测,通产省从没失过手;创新型项目是“无人地”,创新的本质就是谁都不能预知结果。
第4章 3.五代机计划和五代机研究所
为什么失败(第 4 章):五代机没证明能干传统计算机干不了的活,逻辑编程和并行天生矛盾,后期又撞上互联网崛起。
五代机的技术路线出错,核心原因是缺乏理论指导。
第4章 6.结局和教训
作者也承认另一面:
也许五代机并非失败,只是各种技术此起彼伏的一个阶段。
第4章 6.结局和教训
各国的反应(第 4 章):美国组建微电子与计算机技术联盟,英国投入阿尔维计划后很快放弃,欧共体启动 ESPRIT。作者讥讽借日本威胁论向政府要钱的人,也讥讽拿日本案例教学的商学院:
商学院教学的信用似乎在很大程度上建立在人们的健忘之上。
第4章 5.美国和欧洲对日本五代机计划的反应
他还反复拿当年的日本和今天的中国作类比。另一个代价落在神经网络上。日本其实有两位神经网络先驱:福岛邦彦 1980 年提出的“新认知机”(Neocognitron)是今天卷积神经网络(CNN)的源头,甘利俊一是最早用神经网络处理语言这类时序问题的人里最知名的一位(第 5 章)。日本总务省 2016 年发布《下一代人工智能促进战略》,承认日本在大数据和机器学习上已经全面落后于欧美,报告里还特意提到这两位先驱,用来鼓励日本的研究者(第 4 章)。作者的评语是:
但事实上,在福岛邦彦和甘利俊一的壮年,日本把资金都投到了五代机项目,他们没赶上好时候。
第4章 7.日本还有机会吗:日本下一代人工智能促进战略
计算机科学的进步主要是由两件事驱动的:机器太慢;写程序太慢。
第4章 4.并发Prolog
第 5 章
神经网络:“想啥来啥”与“吃啥补啥”
两派(第 5 章):
前一派,我想用“想啥来啥”来形容;后一派,我称之为“吃啥补啥”,有点类似于中国古代的原始思维。
第5章 开篇
前者是自顶向下的符号派,偏唯心;后者是仿造大脑、自底向上的神经网络派,偏唯物。
三起两落(第 5 章):1943 年麦卡洛克(Warren McCulloch)和皮茨发表开山论文;罗森布拉特(Frank Rosenblatt)发明感知机,被明斯基和佩珀特(Seymour Papert)的《感知机》一书打压,神经网络进入近二十年的寒冬。作者讲了许多人事恩怨:明斯基和罗森布拉特是同一所高中的校友,彼此认识也互相嫉妒;罗森布拉特 1971 年在 43 岁生日那天划船溺亡。
复兴来自物理学(第 5 章):20 世纪 80 年代的复兴靠的是霍普菲尔德(John Hopfield)的网络和连接主义运动。
神经网络的这次复兴和生物学其实没啥关系,它既不是来自生物学的刺激,也没有给生物学送去任何慰藉。
第5章 3.神经网络的复兴
1983—1986 年,辛顿(Geoffrey Hinton)和长期合作者谢诺夫斯基(Terry Sejnowski)在霍普菲尔德网络里引入隐藏单元和概率分布,提出“玻尔兹曼机”。作者转述辛顿的回忆:
他们当时认为,如果大脑像玻尔兹曼机那样工作的话,他们应该获得诺贝尔生理学或医学奖。
第5章 3.神经网络的复兴
后来大脑被证明不是这样工作的;最后得诺贝尔物理学奖的是辛顿和霍普菲尔德。
深度学习(第 5 章):辛顿 2006 年开启深度学习,之后是卷积网络、循环网络,一直到 Transformer。作者给深度学习一个最简短的定义:
把“反向传播”加上“梯度下降”放到多层神经网络上就成了“深度学习”。
第5章 5.希尔伯特第十三问题与神经网络的数学理论
他提醒,数学上证明了只要一个隐层就能逼近任意连续函数,但这只证明了存在,没说怎么构造:
另外,激活函数的选择目前还是“玄学”,缺乏理论依据。
第5章 5.希尔伯特第十三问题与神经网络的数学理论
2024 年诺贝尔奖(第 5 章):霍普菲尔德和辛顿获物理学奖,AlphaFold 的发明者获化学奖。作者认为化学奖是用 AI 做科学,物理奖是用科学为 AI 奠基:
发明人工智能工具的人和使用人工智能工具的人从未如此接近。
第5章 4.AI4Science与Science4AI
第 6 章
向自然学习:从遗传算法到强化学习
另一条生物学脉络(第 6 章):从冯·诺伊曼的细胞自动机,到霍兰德(John Holland)的遗传算法、寇扎(John Koza)的遗传编程,其中一条支线最后演变成巴托和萨顿(Richard Sutton)的强化学习。强化学习长期坐冷板凳,2016 年 AlphaGo 之后一夜成了显学,两人获 2024 年图灵奖。
探索与利用(第 6 章):玩老虎机时,不断尝试不同的摇臂是探索,只在当前回报最高的摇臂上投注是利用。作者借此说人生:
这就像我们的人生,大部分时间在苦干(利用),很少时间可以探索“诗和远方”。
第6章 3.强化学习
第一人称的学习(第 6 章):
如果从写作的角度看,强化学习更像是第一人称叙述,Agent就是“我”,外部世界(包括他人)都是“环境”。
第6章 3.强化学习
第一人称的学习要比第三人称的学习更本质。
第6章 3.强化学习
苦涩的教训会放缓(第 6 章):萨顿 2019 年的短文《苦涩的教训》说,长期看,通用方法加上不断增长的算力,总能胜过注入人类知识的专用方法。作者认为 Scaling Law 正是由此而来,但它的基础是摩尔定律:
但摩尔定律的增长是放缓的,Scaling Law必然也会放缓。
第6章 3.强化学习
大语言模型在概念上就是把数据压缩成程序,从这个意义上,就是“发明机器”。
第6章 2.遗传编程
第 7 章
计算机下棋:机定胜人,人定胜天
锤子派的胜利(第 7 章):从 18 世纪的假下棋机“土耳其人”,到图灵和香农的早期设想,再到许峰雄的“深蓝”1997 年击败卡斯帕罗夫。作者借英国谚语里锤子和钉子的说法,把搞技术的叫锤子派,搞商业模式的叫钉子派:
许峰雄开始并不是下棋的专家,他的胜利是锤子派的胜利。
第7章 4.“深蓝”
“深蓝”团队自己都不认为机器有智能。
人反而下得更好(第 7 章):
在“深蓝”赢了卡斯帕罗夫之后,职业棋手并没有因此而改行,他们反而更多地依赖计算机来训练。
第7章 4.“深蓝”
AlphaGo 和合成数据(第 7 章):AlphaGo 让强化学习成了气候,AlphaZero 完全不用人类棋谱,4 小时学会了人类花百年才掌握的棋艺。
强化学习的一个优势是可以不依赖人类棋谱,通过下棋程序互相博弈获得数据。机器获取的数据的数量和质量远高于人类棋谱。
第7章 5.围棋和AlphaGo
AlphaZero之后,人类在对弈类游戏中被机器淘汰了。
第7章 5.围棋和AlphaGo
从下棋到语言(第 7 章):图灵 1948 年的内部报告用下棋定义模仿游戏,到 1950 年的《计算机与智能》改成了用语言。
很明显,到了1950年,图灵已经意识到语言是比下棋更加通用的智能能力。
第7章 5.围棋和AlphaGo
第 8 章
自然语言处理:规则一路败给统计
七十年范式转换(第 8 章):1954 年乔治敦大学和 IBM 做了第一次机器翻译实验,1966 年一份报告叫停了资助;乔姆斯基(Noam Chomsky)的句法理论统治了语言学;魏森鲍姆(Joseph Weizenbaum)的聊天程序 ELIZA 走红;维诺格拉德(Terry Winograd)的“积木世界”让机器听懂摆积木的指令;然后统计派回归,神经网络接手,直到 Transformer、ChatGPT 和 DeepSeek R1。
乔姆斯基(第 8 章):本章篇幅最大的人物是乔姆斯基。作者说:
乔姆斯基之于语言学和认知科学,就像图灵之于计算机科学。
第8章 2.乔姆斯基和句法分析
他也写乔姆斯基的政治人格:永远怀疑权威,同情人民,读他的作品比听他讲话更有意思,“鸡蛋确实比鸡肉好吃”。
“该不该”(第 8 章):ELIZA 走红后,魏森鲍姆成了技术的“异教徒”:
当大家在争论机器能不能最终超越人类时,他指出这不是“能不能”的问题,而是“该不该”的问题。
第8章 3.ELIZA和PARRY
统计派又来了(第 8 章):IBM 用统计方法做语音识别和机器翻译,有一句流传很广的话:
我每开除一名语言学家,我的语音识别系统的性能就提高一点。
第8章 5.统计派又来了
双向和单向(第 8 章):2017 年 Transformer 出现后,谷歌走双向的 BERT,OpenAI 走只预测下一个词的 GPT。直觉上双向应该更强,早期 GPT 也确实不如 BERT,直到 2020 年 GPT-3 反超,大家又一窝蜂转向预测下一个词。作者说 ChatGPT 之后进步以月计,开源是加速的关键原因之一,2025 年初开源的 DeepSeek R1 赢得了全球同行的由衷赞佩。
这给人一种印象:自然语言处理的进步也呈现某种摩尔定律。
第8章 7.深度学习是解决语言问题的终极手段吗?
解决了就不算了(第 8 章):
就像一个哲学问题找到了科学的表述方式(formulation)后,就不再是哲学问题一样,一个人工智能问题一旦被解决,就不再是人工智能问题。
第8章 9.回顾和展望
2011 年 MIT 的一次研讨会上,乔姆斯基批评统计方法和神经网络是黑盒子,没有提供解释;谷歌的诺维格(Peter Norvig)回应说,语言学规则在自然语言处理上根本没用。作者总结:
一种人力图打造实用的工具,没有解释也能凑合,他们是不求甚解的工程师;另一种人寻求终极的知识,他们是科学家。
第8章 9.回顾和展望
第 9 章
语言等于思维吗
乔姆斯基被“打了脸”(第 9 章):第 3 版新增的这一章从 2023 年乔姆斯基在《纽约时报》撰文批评 ChatGPT 说起。
这大概也是崇拜过乔姆斯基的两代人的普遍失望:乔老爷老了。
第9章 章首导言
但他的立场是基础(第 9 章):作者的论证是:乔姆斯基一直主张思维由语言生成;最复杂的一类文法等价于图灵机;所以承认语言就是思维,就等于承认图灵机可以思维。
如果承认语言等于思维,实际上承认了图灵机可以思维。
第9章 1.思维即语言?
虽然乔姆斯基在技术上对ChatGPT可能有所误判,但他“思维即语言”的立场是大语言模型引发的这场革命的哲学基础之一。
第9章 2.思维不等于语言?
为什么大模型更震撼(第 9 章):十几年前深度学习解决了语音和视觉,人们只是兴奋;大模型却让人震撼:
直到2022年ChatGPT在语言能力上的突破才使人们意识到人性可能被冒犯。语言要比听觉和视觉更接近人性。
第9章 1.思维即语言?
记忆还是压缩(第 9 章):
经验主义者会把学习看作记忆,而承认丘奇-图灵论题的人会把学习看作压缩。
第9章 1.思维即语言?
AGI 和世界模型(第 9 章):MIT 的塔南鲍姆(Joshua Tenenbaum)等人认为大模型只有语言的形式能力,没有功能能力,所以思维不等于语言。作者认为这没有提出新东西。他主张多模态模型应以语言模型为基座,并认为“空间智能”“世界模型”是错过大模型的人的借口。
通用人工智能(AGI)不过是由不熟悉计算理论的人提出的口号,如果我们认可语言即思维,那么AGI的标准就是语言,无关乎其他模态,这就又回到了图灵测试。
第9章 1.思维即语言?
人类专属的技能不多了,难道我们要等到机器证明了黎曼猜想才能被彻底打服吗?
第9章 2.思维不等于语言?
第 10—11 章
人是机器吗,什么是学习
人是机器吗(第 10 章):作者把这个古老的问题一步步归约成“人是数字计算机吗”,再用两条计算理论来回答。丘奇-图灵论题:一切足够强的计算装置都和图灵机等价。相似性原则(又称扩展的丘奇-图灵论题):这些装置互相模拟,只需要多项式的代价。作者说这两条都无法证明:
这是归纳,不是演绎,所以这不是数学定理,更像是物理定律。
第10章 1.丘奇-图灵论题
图灵机的强大能力恰恰是因为它的简单。
第10章 1.丘奇-图灵论题
他的回答是:
如果我们认可丘奇-图灵论题和相似性原则,那么人就是图灵机。
第10章 7.超计算和人工智能
作者还讨论了实数计算模型和量子计算能否“超计算”,认为“超级智能”是一个模糊的伪概念,并批评人工智能从业者普遍缺乏计算理论训练:人们常把神经网络近 20 年的衰败归咎于明斯基的《感知机》,可神经网络研究者难道不该反省自己数学和计算理论功底的欠缺?
我们不能指望畅销书作家代替我们回答,而是要自己思考、自己回答。
第10章 6.计算理论的哲学寓意
大语言模型的先知(第 11 章):第 3 版新增的这一章是全书理论的高潮。1956 年前后,麦卡锡提出“图灵机求逆”的问题:看到输出,猜输入。所罗门诺夫(Ray Solomonoff)把它改写成“给定一个序列的初始段,预测这个序列的后续部分”,这正是今天大语言模型的预测下一个词(next token prediction)。归纳就是找能生成数据的最短程序。
所罗门诺夫可算是大语言模型的先知。
第11章 1.背景
在这个意义上,学习可以被当作压缩。
第11章 2.所罗门诺夫归纳
柯尔莫哥洛夫(Andrey Nikolaevich Kolmogorov)和蔡汀(Gregory Chaitin)后来独立得到同一个概念,作者合称 SKC 理论。他据此纠正一个流行说法:
需要注意,次优压缩仍然属于无损压缩。
第11章 7.进展和应用
推断和推理(第 11 章):作者说 inference 更合适的译法是统计意义上的“推断”,有别于逻辑意义上的“推理”(reasoning):
人工智能的逻辑派和统计派,如果都是讲中文的,估计就打不起来了。
第11章 6.本内特与逻辑深度
压缩是人的本性(第 11 章):作者用这套理论重新解释了波普尔的证伪、库恩的范式和休谟的归纳问题,最后仿亚里士多德“求知是人的本性”说“压缩是人的本性”,仿笛卡儿说“我压缩,故我在”。
回顾了SKC复杂性理论的发展过程后,再来看大语言模型,我们会觉得也许不是理论落后于实践,而是太超前了。
第11章 9.结论
第 12—14 章
哲学家、生死和教科书
哲学家(第 12 章):这一章讲三位哲学家:德雷弗斯和他的《计算机不能做什么》、塞尔(John Searle)和他的“中文屋”、普特南(Hilary Putnam)和他的“缸中脑”。作者对前两位很不客气,认为德雷弗斯靠“还不能做什么”蹭热点;对“中文屋”,他的回答是理解本来就是社会性的,戴眼镜算看见、坐飞机算飞,作为一个系统的“中文屋”为什么不算理解?他认为普特南是真正的内行,他的批评值得认真听。作者也不全护短:
不过人工智能的乐观派也该吸取点儿教训:老老实实干活,没事别瞎吹。
第12章 1.德雷弗斯和《计算机不能做什么》
理解是一个社会现象,而不是一个独立的哲学概念或一种个人行为。
第12章 2.塞尔和“中文屋”
让科学家写一本《哲学家不能做什么》远比让哲学家写一本《科学家不能做什么》容易得多。
第12章 4.给哲学家一点忠告
生死(第 13 章):全书唯一的对话体。作者虚构了一段和苏格拉底的对话:换胳膊、换心、换身体、把记忆移植到别人的大脑,“我”还是“我”吗?他一步步承认“我之所以是我”在于记忆和自我意识,于是生死的界限模糊了,永生在原理上可能。
功能和实现可以分开,意识是功能,身体只是实现。
第13章
永生只能解决那些给人无限时间就可以解决的问题
第13章
教科书(第 14 章):第 3 版新增。作者用几代人工智能教科书看学科路线的摇摆,例如尼尔森(Nils J. Nilsson)从 1965 年的《学习机》到晚年未完成的机器学习书稿;罗素(Stuart Russell)和诺维格的《人工智能:现代方法》四个版本的增删;ChatGPT 让自然语言处理教科书大段失效。
几本书既映射了尼尔森的职业生涯,也见证了人工智能学科的变迁:从机器学习起,到机器学习终。
第14章
相较于那几本经典的物理学教科书,人工智能教科书缺乏第一性原理,即计算理论,这也使得人工智能的内容给人以飘忽不定的感觉。
第14章
第 15—16 章
智能的进化和三派的融合
用算力测度文明(第 15 章):人类的智力优势来自大脑皮层的神经元数量,东西方文明的比较可以看能耗,在百年、几十年的尺度上,作者主张用全社会的算力来测度文明。
O 点(第 15 章):作者把摩尔定律和能效提升逐年放缓的现象统称为“尼克定律”,认为它们终将撞上物理上的能耗极限(兰道尔极限),他把那个时刻叫“遗忘点”,即 O 点。他拟合的结果是 O 点约在 2080 年之后。
人工智能依靠的Scaling Law也是摩尔定律和库米定律的自然结果。
第15章 4.算力与能耗
提升计算的能效将是计算机科学和工程最重要的课题。
第15章 4.算力与能耗
会有超级智能吗(第 15 章):作者批评赫拉利(Yuval Noah Harari)、博斯特罗姆(Nick Bostrom)不懂计算理论,分不清“超计算”和“超级计算”。
每一次高潮都是一个旧哲学思想的技术再包装,而每一次衰败都源自高潮时期的承诺不能兑现。
第15章 6.会有超级智能吗?
一个令人迷茫的问题是:不知道是奇点先来还是O点先来?也许O点先来是更人道的。
第15章 6.会有超级智能吗?
三派(第 16 章):全书总结。作者把人工智能分成逻辑主义、连接主义、自然主义三派,不用常见的“行为主义”,理由是机器人学没有统一的理论基础:
任何东西沾了“主义”,都不是闹着玩儿的,凡“主义”都要有理论基础。
第16章
规则派更像计划经济,而统计派更像自由市场经济。
第16章
他认为统计派的难题(图像、语音)已经有解,符号派的难题(定理证明)尚无曙光,但各派正在融合:深度学习加强化学习,用强化学习做定理证明,用强化学习提升大语言模型的推理。
当工程问题更好地被理论解释并囊括时,派别的分歧也许是天真和幼稚的。
第16章
人工智能的核心问题正在被归约到几个理论(计算理论和学习理论)问题。
第16章