《人工智能要义》
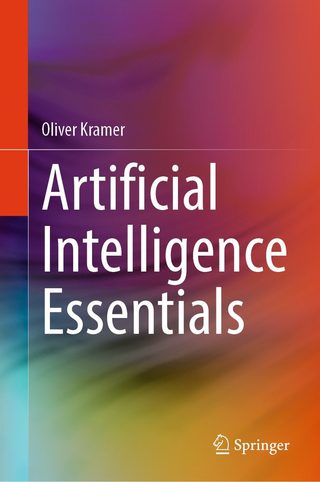
- 出版时间
- 2026年5月
- 页数
- 91页
- 作者单位
- 德国奥尔登堡大学
- 中文书名
- 本页自译
- 原作名
- Artificial Intelligence Essentials
- ISBN
- 9783032066367
我的读书笔记 · BOOK OVERVIEW
一本 70 页的 AI 教材,用手算讲透原理
《人工智能要义》(暂译,未查到中文版)是 Springer 出版的一本很薄的人工智能(Artificial Intelligence, AI)入门教材,正文只有 70 页。作者 Oliver Kramer 在德国奥尔登堡大学的计算智能实验室工作,前言写于 2025 年 7 月。他在前言里说,这本书讲 AI 的基本算法、技术和关键原理,从机器学习、深度学习一直讲到大语言模型和智能体;重点是怎样实现、怎样应用,用动手练习和真实例子帮读者理解。
注意力的三种视角
- 查询 Q找什么这个词在找什么
- 键 K有什么这个词能提供什么
- 值 V给什么这个词贡献出的信息
第 6 章,p.40
全书 9 章分四部分:机器学习(k 近邻、k 均值),深度学习(多层感知机、卷积神经网络、注意力),大语言模型(大语言模型、智能体),优化(遗传算法);书后有三个附录,分别是常用数据集与基准、最低限度的数学、Python 入门。每章的写法大致相同:先讲概念,用几个“信息框”补充相关知识,再用几个数字手算一遍,然后给一段可以在 Google Colab 上运行的代码,最后是习题。
这份笔记按章记各章的核心概念,并尽量用书里的手算例题把概念讲具体。书中的代码和具体的模型版本更新很快,笔记从略。
本书的设计是把理论和实践结合起来,带你动手探索各种 AI 方法。
This book is designed to blend theory with practice and guide you through Hands on exploration of AI methods.
第1章 1.3 How to Use This Book,p.2
第 1 章
AI 是什么,怎样走到今天
一句话定义(第 1 章):作者给 AI 下的定义很短:能学习、推理、做决策的系统。现代 AI 靠的是深度学习(deep learning)和神经网络(neural networks),用来处理语言、识别图像、自动做决策。
人工智能(AI)指能够学习、推理并做出决策的系统。
Artificial Intelligence (AI) describes systems that learn, reason, and make decisions.
第1章 1.1 What Is AI?,p.1
作者说,早期的 AI 用基于规则的系统(rule-based systems),当前的进展则来自在大数据集上的机器学习(machine learning)。作者接着说,大语言模型(Large language models, LLMs,在海量文字上训练、能读写人类语言的模型)用 Transformer 网络来写文字、帮人编程、解推理题;智能体 AI(Agentic AI)又在大语言模型上更进一步。
智能体 AI 扩展了这些模型:它把大语言模型和自动化连接起来,在很少的人工干预下完成多步任务。
Agentic AI extends these models. It connects LLMs with automation and performs multi-step tasks with minimal human input.
第1章 1.1 What Is AI?,p.1
他还说,AI 不只处理语言,也能生成图像、精通复杂的游戏、控制机器人,正在进入医疗、金融和科学研究。前言开头的判断是:
人工智能比以往任何时候都更重要。它已经成为许多产品和我们日常生活中不可分割的一部分,甚至取代了某些劳动任务。
Artificial Intelligence is more important than ever before. It has become an integral part of many products and our daily lives, even replacing certain labor tasks.
前言,p.v
十年一段的简史(第 1 章):
- 1950 年代,AI 诞生:图灵(Alan Turing)用图灵测试(Turing Test)提出“机器能不能有智能”的问题;1956 年达特茅斯会议(Dartmouth Conference)上,约翰·麦卡锡(John McCarthy)提出了“人工智能”这个名称。
- 1960 年代,早期系统:魏泽鲍姆(Joseph Weizenbaum)写出了对话程序 ELIZA。
- 1970 年代,第一次 AI 寒冬(First AI Winter):硬件太弱、期望又不切实际,经费和兴趣都下降。
- 1980 年代,专家系统(Expert Systems):把人的知识写成规则的工具重新引起兴趣,并在商业上成功。
- 1990 年代,新突破:1997 年 IBM 的深蓝(Deep Blue)击败国际象棋冠军卡斯帕罗夫(Garry Kasparov)。
- 2000 年代,机器学习兴起:从数据里学的方法占了主导,支持向量机(SVMs)、决策树(decision trees)、随机森林(random forests)都很有效。
- 2010 年代,深度学习:神经网络加上图形处理器(GPU)改变了 AI;AlexNet 赢得 2012 年 ImageNet 图像识别竞赛;2017 年 Vaswani 等人提出的 Transformer 架构重塑了自然语言处理。
- 2020 年代,大语言模型:GPT 等大模型能写文字、写代码、做创意工作,ChatGPT 等生成式 AI(Generative AI)展示了很强的实用价值。
这本书怎么用(第 1 章):书里讲机器学习用 scikit-learn 和 keras 两个 Python 库,跑大语言模型用 ollama。代码旁边有二维码,链接到可以在线运行的 Google Colab 笔记本;“信息框”(Info Boxes)用简短的篇幅讲清一个概念或方法。作者还推荐了六本教科书,包括 Russell 与 Norvig 的 *Artificial Intelligence: A Modern Approach*、Goodfellow 等人的 *Deep Learning*、Bishop 的 *Pattern Recognition and Machine Learning*、带 Python 代码的 *Dive into Deep Learning*,以及两本统计学习的书。第 1 章的习题是:用自己的话说什么是 AI,列出 AI 史上的里程碑,装好 Python 环境,在 Colab 上运行一行 `print("Hello, AI!")`。
第 2 章
监督学习:k 近邻
从带标签的数据里学(第 2 章):监督学习(Supervised learning)是 AI 的核心思想:给模型一批已经标好答案的例子,让它学会预测答案。比如看大量标好“猫”“狗”“汽车”的图片,学会认图;在医疗上,根据血压、胆固醇、年龄估计患病风险。标好的答案叫“真实标签”(ground truth)。训练就是不断调整模型的参数,缩小预测和真实标签之间的差距。
把每个例子变成空间里的一个点(第 2 章):每个例子都用几项数据来描述,这几项叫特征(features)。拿书里的医疗例子来说,一个病人可以用血压、胆固醇、年龄三项来描述。把每项特征当作一根坐标轴,每个病人就是三维空间里的一个点;特征有几项,空间就有几维,几十、几百维也是同样的道理,只是画不出来。特征可以是数值,也可以是类别,或者两者混用。
两类任务(第 2 章):监督学习按答案的样子分两类。
- 分类(classification):答案是几个类别中的一个,比如一张图是猫、狗还是汽车。
- 回归(regression):答案是一个连续的数值,不限于几个固定选项。
学结构,求泛化(第 2 章):作者说,模型要学的是这个空间里的结构,也就是把输入和答案联系起来的规律:哪一片的点属于同一类,答案又怎样随位置变化。他提醒,这些规律多数只是相关,有时才是因果。学会了结构,来一个没见过的新点,看它落在空间的哪一片,就能给出答案。对没见过的数据也能预测准确,叫泛化(generalization)。和泛化相反的是死记硬背:模型把训练数据里的噪声也记住了,见过的答得好,没见过的却答不好,这就是下文要讲的“过拟合”。
监督学习能否成功,取决于数据质量、数据多样性,以及模型提取稳定而有意义的模式的能力。
The success of supervised learning depends on data quality, data diversity, and the model’s ability to extract stable and meaningful patterns.
第2章 2.1 Supervised Learning,p.7
k 近邻:看离你最近的邻居(第 2 章):k 近邻算法(k-nearest neighbors, KNN)是最简单的分类方法之一。来了一个新点,就在训练数据里找离它最近的 k 个点,这 k 个点里哪个类别最多,新点就归哪类。距离通常用欧氏距离(Euclidean metric,就是平面上两点间的直线距离,推广到多个特征)。它不对数据的分布做任何假设,书里称为“非参数”(non-parametric)方法,所以简单、灵活。
k 近邻遵循的思路是:相似的点往往有相似的结果。
It follows the idea that similar points tend to share similar outcomes.
第2章 2.2 KNN,p.8
书里的手算例子:三个训练点,x1=(1.0, 2.0) 蓝色,x2=(4.0, 1.0) 蓝色,x3=(6.0, 5.0) 红色;要给新点 (4.5, 2.5) 分类,k=1,只看最近的一个邻居。新点到三个点的距离分别约为 3.54、1.58、2.92,以到 x2 为例:横向差 0.5、纵向差 1.5,平方相加 0.25+2.25=2.50,开方约 1.58。最近的是 x2,所以新点判为蓝色。
k 取多大(第 2 章):书里画了 k=1、3、50、200 四种情况下的分类边界。k=1 时边界弯弯曲曲,贴着每个点走;k=3 时边界变平滑,不那么容易被个别噪声点带偏;k 取 50、200 时,区域又宽又稳,但模型开始忽略局部细节。这对应两个基本概念:过拟合(Overfitting),模型太复杂,把噪声也记住了,换一批没见过的数据就表现差;欠拟合(Underfitting),模型太简单,连数据的基本结构都抓不住,训练数据上也表现差。k 太小容易过拟合,k 太大可能欠拟合。
另一个要点是先把特征缩放到同一个范围,常用最小—最大归一化(Min-max normalization),把每个特征压到 0 到 1 之间。作者说这对 KNN 很重要,因为特征的量纲不同(比如一个以米计、一个以毫米计),会直接影响距离的计算。
怎样评价分类结果(第 2 章):把预测结果分成四格,叫混淆矩阵(confusion matrix):真阳性(TP,实际是正、预测也是正)、假阳性(FP,实际是负、却预测成正)、假阴性(FN,实际是正、却漏掉了)、真阴性(TN)。由此算三个指标:
- 准确率(Accuracy):所有预测里对了多少;
- 精确率(Precision):预测为正的里面,真正是正的有多少;
- 召回率(Recall,又叫灵敏度 sensitivity):实际为正的里面,被找出来的有多少。
书里的例子:测试 100 个样本,真阳性 40、假阳性 5、假阴性 10、真阴性 45。准确率是 (40+45)/100=0.85;精确率是 40/(40+5)≈0.89,即预测为正的 45 个里有 40 个对;召回率是 40/(40+10)=0.8,即实际为正的 50 个里找出了 40 个。
数据集不平衡时,准确率可能会误导人。
Accuracy can be misleading when the dataset is imbalanced.
第2章 2.4 Precision and Recall,p.11
交叉验证与网格搜索(第 2 章):只把数据切一次、分成训练集和测试集,结果容易受运气影响。k 折交叉验证(k-fold cross-validation)把数据平均分成 k 份,每次拿其中一份做检验、其余做训练,轮流 k 次再取平均,估计更稳。变体有保持各类比例不变的分层 k 折(stratified k-fold),以及每次只留一个样本做检验的留一法(LOOCV)。网格搜索(Grid search)则把要调的参数(比如 k 取 1、3、5、7、9)逐一试过,每个都用交叉验证打分,挑平均准确率最高的。
交叉验证对小数据集很有用,它通过在没见过的数据上反复测试,帮助发现过拟合。
Cross-validation is useful for small datasets and helps detect overfitting through repeated testing on unseen data.
第2章 2.5 Cross-Validation,p.11
网格搜索是穷举式的,但参数多或取值范围宽时,代价会变得很高。
Grid search is exhaustive but becomes expensive when many parameters or wide ranges are used.
第2章 2.5 Cross-Validation,p.12
KNN 也能做回归:取 k 个最近邻居目标值的平均作为预测,用均方误差(Mean Squared Error, MSE,预测值与真实值之差的平方的平均)评估。本章代码在葡萄酒数据集(Wine dataset)上把整套流程走了一遍:划分数据、用 5 折交叉验证挑最好的 k、输出分类报告和混淆矩阵。作者顺带解释,代码里随机种子设成 42,是向道格拉斯·亚当斯(Douglas Adams)的小说《银河系漫游指南》(*The Hitchhiker's Guide to the Galaxy*)致敬,书中说 42 是“生命、宇宙以及一切”终极问题的答案(第 2 章)。
第 3 章
无监督学习:k 均值
没有标签,自己找结构(第 3 章):无监督学习(Unsupervised learning)的数据只有特征,没有答案,目标是发现数据里藏着的模式。主要有两类方法:聚类(Clustering),把相似的点分到同一组(簇)里,同一簇的点彼此之间比跟别的簇更像;降维(Dimensionality reduction),把很多维的数据压到少数几维,同时保留主要结构。
由于没有预先设定的输出,无监督学习适合用来做探索性分析、异常检测和特征提取。
Because no predefined outputs exist, unsupervised learning is useful for exploratory analysis, anomaly detection, and feature extraction.
第3章 3.1 Unsupervised Learning,p.15
k 均值的四步(第 3 章):k 均值(k-means)把数据分成 k 个簇,做法是一个循环:
- 随机放 k 个中心点(centroids);
- 每个数据点归到离它最近的中心;
- 把每个簇里所有点的坐标取平均,作为这个簇的新中心;
- 重复第 2、3 步,直到没有点再换簇。
书里的图演示了三个簇的四次迭代:中心点随着数据点在簇之间移动而移动,最后停下来。
当没有任何点再改变所属的簇时,这个过程就稳定了。
The process stabilizes when no point changes its assignment.
第3章 3.2 K-Means,p.16
怎样算分得好(第 3 章):簇内方差(Intra-cluster variance)衡量簇里的点离中心有多近,越小说明簇越紧凑;k 均值做的就是让它尽量小。
簇间方差应当较高,这样各个中心才能彼此分得开,各簇界限分明。
Inter-cluster variance should be high to keep centroids well separated and clusters clearly distinct.
第3章 Info Box: Intra-Cluster Variance,p.17
本章代码自己写了一个 k 均值函数。书中交代,经典做法是从数据点里随机挑 k 个当初始中心、一直算到收敛;书里的版本为了演示,改为在数据的取值范围内均匀随机放中心、只迭代固定次数。习题里作者提了三个值得想的问题:为什么要事先定好 k、怎样找合适的 k;簇的形状奇怪或互相重叠时 k 均值会出什么问题;初始中心放在哪里为什么要紧(第 3 章)。
第 4 章
从感知机到多层网络
最简单的神经元(第 4 章):神经网络的灵感来自大脑。书里先介绍了自然神经元:树突(dendrites)接收信号,胞体(soma)是细胞主体,轴突(axon)向外输出,信号经过突触(synapses)传递,突触可以变强或变弱。赫布学习(Hebbian learning)常被概括为“一起放电的细胞会连在一起”:两个相连的神经元同时活跃,它们之间的突触就变强。这种可塑性(plasticity)支撑着学习和记忆。
感知机(perceptron)是最简单的人工神经元,1950 年代提出。它把每个输入乘上一个权重,加起来,再加一个偏置(bias),最后经过一个激活函数(activation function)决定输出。作者把这概括成一句口诀:
输入乘权重,加上偏置,再激活。
Input times weight, add bias, activate.
第4章 4.1 Simple Perceptrons,p.23
现在常用的激活函数是 ReLU:正数原样通过,负数一律变成 0。作者说它有助于缓解“梯度消失”(vanishing gradient problem,网络层数多时,用来调整参数的信号越传越弱)。最初的感知机用的是阶跃函数(step function),只能用一条直线把两类分开,所以只能处理“线性可分”的问题。它能表示“与”(AND)、“或”(OR),却表示不了“异或”(XOR,两个输入不同时才为真),因为没有一条直线能把异或的两类分开。
尽管有这个局限,“根据误差更新权重”的思想仍然至关重要。它为反向传播打下了基础,而训练现代多层网络靠的正是反向传播。
Even with this limit, the idea of updating weights based on errors was crucial. It laid the groundwork for backpropagation, which trains modern multi-layer networks.
第4章 4.1 Simple Perceptrons,p.24
多层感知机(第 4 章):多层感知机(Multi-Layer Perceptrons, MLPs)把很多“稠密层”(dense layers,每个输出都和每个输入相连的一层)叠起来,中间的叫隐藏层(hidden layers)。每层先做“权重矩阵乘输入、加偏置”,再过一个非线性的激活函数。常见的激活函数有三个:sigmoid(从 0 平滑过渡到 1)、tanh(取值在 −1 到 1 之间)、ReLU。正是这些非线性,让网络能逼近复杂的关系,做到单个感知机做不到的事。
书里算了一个小例子:一个 2 个输入、3 个输出的稠密层,输入 x=(1, 2),加权求和后得到 (−1.5, 2.0, 2.5),经过 ReLU,负数变 0,输出 (0, 2.0, 2.5)。
做分类时,最后一层的输出(logits,还没变成概率的原始分数)通常再经过 Softmax,变成一组非负、加起来等于 1 的概率。类别标签则用独热编码(One-hot encoding)表示:K 个类别就用长度为 K 的向量,只有对应位置是 1。书里用机器人零件举例:抓手(gripper)是 [1, 0, 0, 0],激光雷达(lidar)是 [0, 1, 0, 0],电机、摄像头依此类推。
反向传播(第 4 章):反向传播(Backpropagation)是训练神经网络的标准算法,分两段。前向传播(forward pass):用当前的权重算出预测。反向传播(backward pass):算出误差对每个权重的“梯度”(gradient,误差随这个权重变化的快慢和方向),再按梯度下降(gradient descent)把权重往减小误差的方向挪一点,挪多少由学习率(learning rate)决定。训练要把数据过很多“轮”(epochs),每轮分成一个个小批量(mini-batches)更新。
书里的手算例子只有一个输入、一个权重,用 ReLU、不加偏置,误差用均方误差:
- 输入 x=2,目标 y=4,初始权重 w=1.0,学习率 0.1;
- 前向:预测 = 1.0×2 = 2,误差 L = ½×(2−4)² = 2(乘 ½ 是为了求导时消掉系数 2);
- 反向:按链式法则(chain rule,把复合函数的导数拆成几段相乘),误差对权重的梯度 = (2−4)×1×2 = −4;
- 更新:新权重 = 1.0 − 0.1×(−4) = 1.4;新预测 = 1.4×2 = 2.8,比原来的 2 更接近目标 4。
两个训练技巧(第 4 章):随机梯度下降(Stochastic Gradient Descent, SGD)每次只用一个样本更新,误差上下波动;但作者说,这种噪声有助于跳出浅的低谷和“鞍点”(saddle points,某些方向上是低谷、另一些方向上是高点的位置)。实际用得最多的是小批量梯度下降(Mini-batch gradient descent),每次用 32 或 128 个样本,更稳也更快。另一个技巧是丢弃法(Dropout):训练时随机让一部分神经元的输出变成 0,测试时再全部启用。作者说,这样做迫使网络学到有冗余的表示,泛化能力更好。
本章代码用 scikit-learn 的 MLPClassifier 在手写数字数据集上(1797 张 8×8 的小图)训练了一个两层隐藏层(64 和 32 个单元)的网络。习题里有一道:为什么感知机学不会异或,怎样解决(第 4 章)。
第 5 章
卷积神经网络:让机器看图
不再手工设计特征(第 5 章):卷积神经网络(Convolutional Neural Networks, CNNs)改变了图像识别。过去要靠人手工设计特征(handcrafted features),CNN 直接从原始像素里学出边缘、纹理、形状。
CNN 不再需要手工设计的特征,而是以数据驱动的方式,直接从原始输入中学习。
CNNs remove the need for handcrafted features and learn from raw inputs in a data-driven way.
第5章 5.1 Image Recognition,p.31
重大突破是 2012 年的 AlexNet:Krizhevsky、Sutskever、Hinton 在 ImageNet 数据集上展示了深层 CNN 的威力。此后 CNN 成了医疗、自动驾驶、安防的标准工具(第 5 章)。
卷积层:拿小窗口在图上滑(第 5 章):卷积层(Convolutional layers)是 CNN 的核心。它用一些小矩阵,叫滤波器(filters)或卷积核(kernels),通常 3×3 或 5×5,在图像上一格一格地滑动。每到一处,只看窗口盖住的那一小块(这一小块叫感受野,receptive fields),把窗口里的数和对应像素逐个相乘再相加,得到输出图上的一个数;滑完一遍,就得到一张“特征图”(feature map)。作者说,低层检测简单的结构,深层检测更复杂的结构。
几个相关的概念:步幅(stride),窗口每次移动几格,大于 1 可以省计算;零填充(zero padding),在图像四周补一圈 0,免得输出越卷越小;滤波器组(filter bank),一层里有很多个滤波器,每个都同时看所有输入通道,各出一张特征图,比如 128 个输入通道、256 个滤波器,就得到 256 张特征图。
手算一次卷积(第 5 章):3×3 的输入第一行 1、2、0,第二行 3、1、2,第三行 0、1、1;2×2 的滤波器第一行 1、0,第二行 −1、1;步幅 1,不补零。窗口放在左上角,盖住 1、2、3、1,与滤波器对应相乘再相加:1×1 + 2×0 + 3×(−1) + 1×1 = −1。依次挪到右上、左下、右下,分别得 3、4、1,所以输出是一张 2×2 的特征图:第一行 −1、3,第二行 4、1。
池化与数据增强(第 5 章):池化(Pooling)把特征图缩小,同时保留重要的特征。最大池化(max pooling)取每个小区域里的最大值,例如 1、3、2、4 这四个数取 4;平均池化(average pooling)取平均,同一例得 2.5。
池化的主要目的是提供空间不变性,也就是说,不管某个模式出现在输入里的哪个确切位置,网络都能把它认出来。
The primary purpose of pooling is to provide spatial invariance, meaning the network can recognize patterns regardless of their precise location within the input.
第5章 5.4 Pooling,p.34
数据增强(Data augmentation)是把训练图片翻转、旋转、缩放、裁剪、平移、调亮度或加噪声,人为扩大数据集,减少过拟合(第 5 章)。
经典架构与“深”的意义(第 5 章):VGG-19 结构简单统一,是图像分类常用的基准模型:16 个卷积层分成 5 块,每块后面接一个最大池化层,把图缩小一半;最后是三个全连接层(4096、4096、1000 个单元),对应 ImageNet 的 1000 个类别。残差网络(ResNet, Residual Network)用“跳跃连接”(skip connections):每一块只学输入和输出之间的差(残差),再把原输入直接加回去,写成 y=F(x)+x,这样信息和梯度都更容易传过很多层。
残差连接让极深网络的训练保持稳定,使模型可以超过 1000 层。不过,这样的深度需要大量数据。
Residual connections stabilize training in very deep networks and allow models with more than 1000 layers. Such depth, however, requires large amounts of data.
第5章 Info Box: Deepness in Deep Learning,p.36
作者说,网络越深,学到的特征越抽象:前几层认边缘,深层认物体的部件和整个物体。本章代码用 Keras 在 CIFAR-10 数据集(6 万张 32×32 的彩色小图,分飞机、汽车、鸟、猫等 10 类)上搭了一个三层卷积(32、64、128 个滤波器)的网络。章末的课外探索是访问 MIT 道德机器(MIT Moral Machine)网站,做几道自动驾驶的伦理两难题,看看自己的选择暴露了哪些偏见,再想一个设计者可以减少系统偏见的办法(第 5 章)。
第 6 章
注意力与 Transformer
一次看完整个句子(第 6 章):老式的循环神经网络(recurrent neural networks)读句子是一个词一个词往下读,隔得远的两个词很难联系起来,书里叫“长距离依赖”(long-term dependencies)的难题。以 Transformer 为代表的基于注意力(Attention)的模型一次看整个序列,速度也快得多。
Transformer 避开了这个局限。它能建模任意两个词元之间的关系,不论二者相隔多远。
Transformers avoid this limit. They model relations between any two tokens, no matter how far apart they are.
第6章 6.1 Sequence Learning,p.39
作者用一个三个词的句子“AI is fun”讲直觉:fun 这个词可能会特别“注意”AI,于是 fun 最后的向量里就带上了 AI 的信息,模型由此理解两者的联系。
注意力让每个词都能看到整句话,并从中提取有用的上下文。
Attention lets each word view the full sentence and extract useful context.
第6章 Info Box: Attention Intuition,p.39
从词到向量(第 6 章):第一步是把句子切成词元(tokens,模型处理文字的基本单位),得到 [AI, is, fun]。第二步把每个词元换成一组数,叫嵌入(embedding)。为了好算,书里用两维向量:AI=[1, 0],is=[0, 1],fun=[1, 1];真实模型用 512 维或 768 维,训练后用法相近的词会得到相近的向量。注意力本身不区分词的先后,所以还要给每个词加上一个表示位置的向量,叫位置编码(positional encoding),让模型分得清第一、第二、第三个词。
查询、键、值(第 6 章):接着,每个词的向量分别乘上三个学出来的权重矩阵,得到三个新向量:查询(query, Q)、键(key, K)、值(value, V)。作者说,这三个投影是同一个输入的三种视角:
查询向量代表这个词元在找什么。键向量代表这个词元能提供什么。值向量包含这个词元贡献出的信息。
The query vector represents what the token is looking for. The key vector represents what the token offers. The value vector contains the information the token contributes.
第6章 6.2 Attention,p.40
计算分三步:用每个词的查询去和所有词的键做点积(dot product,对应位置相乘再相加,数越大表示越相关),得到相关程度的分数;分数除以键向量维数的平方根(√d_k),防止数值过大,再用 Softmax 变成加起来等于 1 的权重;最后按这些权重把所有词的值向量加权相加。合起来就是书中的公式 Attention(Q,K,V)=softmax(QKᵀ/√d_k)V。每个词由此得到一个新向量,既有它自己的内容,也混进了它所关注的词的信息。
多头注意力(Multi-head attention)是同时并行算好几组注意力,每组(“头”)有自己的投影矩阵,最后把结果拼起来。
每个头都可以关注输入的不同方面,比如句法、语义或位置关系。
Each head can focus on a different aspect of the input, such as syntax, semantics, or positional relations.
第6章 Info Box: Multi-Head Attention,p.41
手算一次注意力(第 6 章):句子是“Robots learn fast”,三个词元的向量分别是 [1, 1]、[1, 0]、[0, 1](为了简单,不加位置编码)。乘上给定的三个权重矩阵后,三个词的查询是 [2, 1]、[2, 0]、[0, 1],键是 [2, 0]、[1, 1]、[1, −1],值是 [1, 3]、[1, 0]、[0, 3]。
以第一个词 Robots 为例:它的查询 [2, 1] 和三个键做点积,得到 4、3、1;除以 √2(键是两维的),约为 2.83、2.12、0.71;经过 Softmax,变成 0.620、0.306、0.074,也就是 Robots 把约 62% 的注意力放在自己身上,约 31% 放在 learn 上,约 7% 放在 fast 上。再按这组权重把三个值向量加权相加,得到 Robots 的新向量约 [0.926, 2.083]。另外两个词同样计算,learn 的权重约为 0.673、0.164、0.164,新向量约 [0.836, 2.509];fast 的权重约为 0.284、0.576、0.140,新向量约 [0.860, 1.272]。作者说,每一行就是对应词元的新的上下文向量。
GPT 与 BERT(第 6 章):Transformer 原本由编码器(encoder)和解码器(decoder)两部分组成,里面是多头注意力、层归一化(Layer normalization,把每个向量的数值拉回稳定范围,让训练更稳)、稠密层和残差连接。GPT(Generative Pre-trained Transformer,生成式预训练 Transformer)只用解码器,按“自回归”(autoregressive)的方式生成文字:根据前面所有的词元预测下一个,一个接一个往下写。它用“掩码自注意力”(masked self-attention),每个词元只能看它前面的词,不能偷看后面的。BERT 只用编码器,前后文同时看,用来理解文字。GPT 先在大量文字上预训练,再针对具体任务微调(fine-tuned)(第 6 章)。
本章最后介绍 Hugging Face 的 transformers 库:其中的 pipeline 工具几行代码就能调用现成的预训练模型,书中示例是判断一句话的情感是正面还是负面;还介绍了 Streamlit,一个写很少代码就能做出交互网页的 Python 框架,适合快速做原型、分享 AI 实验(第 6 章)。
第 7 章
大语言模型:规模、精度、本地运行与提示
基础模型与前沿模型(第 7 章):大语言模型(Large Language Models, LLMs)用 Transformer 搭成,在大量文字上训练,学到语法、事实和简单的推理模式。它先由分词器(tokenizer)把文字切成词、子词(subwords)或字符并编号,然后一次生成一个词元,再转回文字。
大语言模型通常作为基础模型来训练。它们不是为某一个固定任务设计的,而是能适应许多任务。
LLMs are often trained as foundational models. They are not designed for one fixed task but can adapt to many.
第7章 7.1 LLMs,p.49
最先进的大语言模型叫前沿模型。它们代表着当前 AI 能力的边界,但训练需要大量的算力和能源。
State-of-the-art LLMs are called frontier models. They define current AI capability but require high computational and energy resources to train.
第7章 7.1 LLMs,p.49
参数与精度(第 7 章):参数(parameters,模型里需要学出来的那些数)越多,通常能表示越复杂的模式;小模型则胜在速度快、省资源、部署成本低。同一个模型家族往往从能在手机上快速运行的小版本,到做复杂推理的大版本都有,按用途和资源挑。
数值精度(Numerical precision)指模型内部每个数用多少位来存。书中比较了几种格式:16 位浮点数(FP16)比 32 位(FP32)省内存、跑得快,精度只损失一点;8 位、4 位整数(INT8、INT4)更省,主要用在受限的硬件上运行模型。这类低精度格式让大模型也能在资源有限的设备上运行。
在自己电脑上跑模型(第 7 章):Ollama 是一个在本地运行语言模型的轻量工具,支持 macOS、Linux 和 Windows,能运行 Llama、Gemma、Mistral 等开源模型,几条命令就能列出、下载、运行模型。还可以写一个 Modelfile(模型配置文件)定制模型:书中例子以 mistral 为底座,把“温度”(temperature,控制回答随机程度的参数)设为 0.7,再写一句系统提示,让它当一个专答技术问题的助手。Ollama 也支持能同时处理文字和图像的多模态模型,可以描述图片、识别图里的文字、回答关于图片的问题。作者说,Ollama 既能灵活地在本地部署,又把控制权完全留在自己的设备上。
提示的四种写法(第 7 章):
提示是用户和大语言模型之间的主要接口。问题或指令怎么措辞,往往决定了输出的质量。
Prompting is the main interface between users and LLMs. The phrasing of a question or instruction often shapes the quality of the output.
第7章 7.4 Prompting,p.51
书里用同一道算路程的题演示:一只鸟上午飞 6 公里、晚上飞 4 公里,一共飞了多远?
- 零样本提示(zero-shot prompting):直接问。作者说简单任务效果好,复杂或多步的问题可能失败。
- 单样本提示(one-shot prompting):先给一个做好的例子,比如汽车上午 10 公里、晚上 5 公里,答 10+5=15 公里,再问鸟的题。模型会照着例子的思路答,回答更一致可靠。
- 少样本提示(few-shot prompting):给好几个例子,再加一道火车的题(50+30=80 公里),例子越多,模型越能把握题型,遇到复杂或陌生的问题尤其有用。
- 思维链提示(Chain of Thought, CoT):例子里不光给答案,还把中间步骤写出来。书中的例子是面包店卖 3 种松饼、每个 2 美元、每种买 5 个:先算一共 5×3=15 个,再算 15×2=30 美元;然后让模型照这个步骤去解一道书店的同类题。
模型不是直接给出答案,而是被引导着一步一步地解题。
Instead of directly producing an answer, the model is guided to solve the problem step by step.
第7章 7.4 Prompting,p.51
作者说,思维链能提高准确性、可解释性和稳健性,尤其适合逻辑推理、多步数学和科学分析(第 7 章)。
一个聊天机器人和 RLHF(第 7 章):本章代码通过 Ollama 的接口写了一个命令行聊天机器人。关键在于每次请求都把完整的对话历史(一串“谁说了什么”的记录)一起发给模型,模型才能在多轮对话中记住上下文。信息框介绍了基于人类反馈的强化学习(Reinforcement Learning with Human Feedback, RLHF),用来让模型的回答符合人的偏好,通常分三步:收集人对模型回答的评价;训练一个“奖励模型”(reward model)去预测人更喜欢哪种回答;再用强化学习微调大模型,让它多给奖励模型打分高的回答(第 7 章)。
第 8 章
智能体:记忆、工具与协作
大模型本身还不是智能体(第 8 章):作者说,智能体 AI 指在变化的环境里自主地、朝着目标行动的系统。传统模型只是被动地处理输入;智能体能行动、规划、调整,几乎不需要人插手,特点是自己设目标、实时规划、快速适应、根据反馈改策略。
大语言模型默认并不是智能体。只有放进提供记忆、明确推理步骤、工具调用和外部系统连接的智能体框架里,它们才具有智能体的特性。
LLMs are not agentic by default. They become agentic when placed inside agent frameworks that provide memory, explicit reasoning steps, tool usage, and links to external systems.
第8章 8.1 Agents,p.55
多智能体系统(multi-agent system, MAS)由好几个在同一环境里行动的智能体组成,各有各的目标。基于大模型的智能体用自然语言交流、规划和协调,常见的分工有规划者(planner)、执行者(executor)、评估者(evaluator)。作者说,系统整体的行为是从这些互动中涌现出来的。
记忆(第 8 章):记忆让智能体能存下过去的交互、跟踪自己的输出、回看工具返回的结果、调整策略。
没有记忆,基于大语言模型的智能体就是无状态的,无法反思自己之前的行动。
Without memory, an LLM-based agent is stateless and cannot reflect on earlier actions.
第8章 8.2 Agent Memory,p.55
作者说,现在许多架构的记忆是靠提示来实现的:把过去的信息动态塞进模型的“上下文窗口”(context window,模型一次能看到的文字范围)。他把这比作符号 AI(symbolic AI)里经典的“黑板架构”(blackboard architecture):不同模块往同一块共享的“黑板”上读写,一起解题、多步推理、反复改进。记忆还能用来做一致性检查:几条推理路线得出的结果,可以用投票、元推理(meta-reasoning)或事先定好的回退规则(fallback rules)来比较和调和(第 8 章)。
检索增强生成(第 8 章):检索增强生成(Retrieval-Augmented Generation, RAG)让模型的回答以外部文档(比如手册、论文)为依据:先把每份文档转成一组数(嵌入),用户的问题也同样转换;按相似度(通常用余弦相似度 cosine similarity,看两组数的“方向”有多接近)找出最相近的几份文档,把它们和问题一起放进提示里。
模型利用这些上下文生成更好的回答。这能减少幻觉,提高事实准确性。
The model uses this context to generate a better answer. This reduces hallucination and improves factual accuracy.
第8章 Info Box: Retrieval-Augmented Generation,p.56
(幻觉 hallucination,指模型一本正经地编出不存在的内容。)
工具(第 8 章):
模型能生成文字,而工具让它能行动:浏览网页、执行代码、读取文件、分析图像,或者与其他智能体合作。
A model can generate text, but a tool lets it act: browse the web, execute code, read files, analyze images, or cooperate with other agents.
第8章 8.3 Agent Tools,p.57
工具把静态的模型变成了交互式的系统。
Tools turn static models into interactive systems.
第8章 8.3 Agent Tools,p.57
工具就是智能体在需要时可以调用的外部函数。比如一个智能体可以先上网搜索,再从 PDF 里提取内容,运行代码分析结果,最后写出总结。LangChain、CrewAI、AutoGen 这些框架规定了智能体怎样调用工具、读取结果、把一步步串成推理链。工具可以在本机,比如代码解释器(code interpreter);也可以在远端,比如网络接口。书里举的一个工具是 OpenAI 的 Whisper,一个语音转文字(speech-to-text)模型,能处理嘈杂的录音和多种语言(第 8 章)。
两个智能体的小团队(第 8 章):CrewAI 是一个轻量的 Python 框架:给每个智能体定一个角色(role)和目标(goal),分配任务,由框架协调它们的互动。书中例子只有两个智能体:一个“好奇的学生”负责提一个有深度的 AI 问题,一个“AI 专家”负责清楚、深入地回答;两个任务按顺序执行,前一个的结果自动传给后一个。
把角色串联起来,只用语言就能编排多步骤的工作流程。
By chaining roles, you can orchestrate multi-step workflows using language alone.
第8章 8.4 Agents in CrewAI,p.58
书里还列了四个常见的智能体框架:LangChain,把工具和推理串成智能体;LangGraph,用图结构的流程管理智能体的记忆和状态;AutoGPT,把目标拆开、自己执行的自主智能体;CrewAI,按角色分工、带任务规划的多智能体系统。作者说,它们在范围和结构上各不相同,但共同目标都是让大模型在变化的环境里有目的地行动(第 8 章)。
图灵测试与通用人工智能(第 8 章):本章两个信息框回到 AI 的大问题。图灵测试由图灵在 1950 年提出:人只通过文字同时和一台机器、一个人交流,如果分辨不出哪个是机器,机器就算通过。通用人工智能(Artificial General Intelligence, AGI)指像人一样灵活、能在大量不同任务上学习和解决问题的 AI,与只擅长某一件事的“狭义 AI”(narrow AI)相对。
AGI 虽然仍停留在理论层面,却是一个重要的研究目标,围绕它的潜力、风险和时间表,争论很活跃。
While still theoretical, AGI is a major research goal with active debate around its potential, risks, and timeline.
第8章 Info Box: Artificial General Intelligence,p.59
第 9 章、附录
优化:遗传算法,以及三个附录
另一条路:优化(第 9 章):全书最后一部分讲 AI 的另一条主线:优化。
优化就是通过最大化或最小化一个目标函数,在众多候选方案里找出最好的那一个。
Optimization is the task of finding the best solution among many candidates by maximizing or minimizing an objective function.
第9章 9.1 Optimization,p.63
目标函数(objective function)给每个候选方案打分。数值上最简单的例子是“球函数”(Sphere function),x1²+x2²,在原点处最小;符号上的例子贯穿全章:从一堆乱码出发,“进化”出目标字符串 GENETIC ALGORITHMS,打分的办法是数一数有几个字符对上了,这个打分函数叫适应度函数(fitness function)。
许多现实问题能评估一个解的好坏,却给不出解析的或可求导的形式。这类问题就是黑箱优化问题。
Many real-world problems allow evaluation of a solution but do not offer an analytic or differentiable form. These are black-box optimization problems.
第9章 9.1 Optimization,p.63
(前面几章的神经网络靠求导、沿梯度调整参数;黑箱问题求不了导,只能对每个候选解打分。)
把进化论搬进计算机(第 9 章):遗传算法(Genetic Algorithms, GAs)受达尔文自然选择理论(Darwin’s theory of natural selection)启发:变异和重组带来多样性,性状更强的个体繁殖得更多,种群一代代变得更适应环境。在算法里,每个个体代表一个候选解,叫染色体(chromosome),可以是一串 0 和 1、一串数或一串符号;内部的编码叫基因型(genotype),在问题里表现出来的那个解叫表现型(phenotype)。算法反复循环四步:交叉、变异、评估适应度、选择。
常见的一种是 (μ+λ)-GA:μ 个父代通过交叉和变异生出 λ 个子代,然后从父代和子代合在一起的全体里挑最好的 μ 个,作为下一代的父代。作者说,这样强的解能保留下来,新的解又维持了多样性。另一种 (μ,λ)-GA 只从子代里挑,探索得更多,但可能把好的父代丢掉(第 9 章)。
交叉与变异(第 9 章):交叉(Crossover)模仿有性生殖,把两个父代各取一部分拼成子代。最简单的是单点交叉(single-point crossover):随机选一个切点,前半段取父代一、后半段取父代二。书中例子:GENE|TIC ALGORITHMS 和 EVOL|VING SOLUTIONS 在第 4 个字符后切开,拼成 GENEVING SOLUTIONS。这样,已经对上的片段就能在种群里一代代传下去。
变异(Mutation)是随机改动个别字符:每个字符都有一个小概率被换成字母表里的另一个字符,例如 GENETIC ALGORITHMS 变成 GENETIC ALPORITHMS。变异率通常很低,常在 1% 到 10% 之间,既保住好的解,又留出探索的余地。作者说,种群变得过于相似时,变异尤其要紧,否则算法可能过早停在一个不好的解上。
如果个体是一串 0 和 1,变异就是“比特翻转”(Bitflip mutation):以小概率把某一位 0 变 1 或 1 变 0,长度为 N 的串通常取概率 1/N。书中例子 101001 变成 101011,是第五位从 0 翻成了 1(第 9 章)。
手算一代遗传算法(第 9 章):用 (2+3)-GA 进化目标单词 GENETIC(7 个大写字母),适应度是“位置和字母都对的字符数”。
- 第一代两个父代:GAROTAC,适应度 3(第 1、5、7 位的 G、T、C 对);BENEDIR,适应度 4(第 2、3、4、6 位的 E、N、E、I 对)。
- 子代一:取 GAROTAC 前 4 个字符、BENEDIR 后 3 个,拼成 GARODIR;再变异 R→T、O→E,得 GAREDIT,适应度 3。
- 子代二:取 BENEDIR 前 5 个、GAROTAC 后 2 个,拼成 BENEDAC;变异 D→T、A→I,得 BENETIC,适应度 6。
- 子代三:取 GAROTAC 前 3 个、BENEDIR 后 4 个,拼成 GAREDIR;变异 A→N、I→T、R→C,得 GNREDTC,适应度 3。
- 选择:五个个体里,适应度最高的两个是 BENETIC(6)和 BENEDIR(4),它们成为下一代的父代。如此继续,一步步逼近 GENETIC。
本章代码是一个 (10+20)-GA:每代 10 个父代随机两两配对,交叉、变异生出 20 个子代,再从 30 个里挑前 10 个,直到进化出 GENETIC ALGORITHMS。
这个符号遗传算法说明,简单的进化机制就能发现有结构的序列。
This symbolic GA shows how simple evolutionary mechanisms can discover structured sequences.
第9章 9.6 GA in Python,p.69
信息框还介绍了神经进化(Neuroevolution):用进化算法去设计神经网络本身,把“这一层是什么类型、有几个卷积核、用什么激活函数”编成一串 0 和 1,再让交叉和变异在这些编码上一代代进化出更好的网络结构。章末的课外探索是了解谷歌的 AlphaEvolve,一个把大语言模型和进化搜索结合起来设计新算法的系统(第 9 章)。
三个附录(附录):附录 A 是一张常用数据集的表,列出全书用过的鸢尾花(Iris,150 个样本、4 个特征、3 类)、葡萄酒、乳腺癌、手写数字、加州房价、MNIST、CIFAR-10 等数据集的规模和任务类型,还列了 GSM8K(小学数学应用题)等几个评测大语言模型的基准,以及两个检验进化算法的标准问题:OneMax(让一串 0 和 1 里的 1 尽量多,最优解是全 1)和 Sphere(各坐标平方和,最小值在原点)。附录 B 是最低限度的数学:向量与矩阵、点积、转置、范数、矩阵乘法,均匀分布和伯努利分布,以及链式法则(例如 sin(x²) 的导数是 cos(x²)·2x)。
两个向量的点积,是衡量它们有多相似的一个简单方法。
The dot product between two vectors is a simple way to measure how similar they are.
附录B B.1 Vectors and Matrices,p.73
(第 6 章注意力里“查询和键做点积”,用的就是这个意思:方向越一致,点积越大。)
讲链式法则时,作者说反向传播正是用它一层层算出复合函数的梯度,这就是第 4 章手算例子里那一步的数学来历(附录)。
附录 C 是面向机器学习的 Python 入门:安装和 Google Colab,基本数据类型,循环与条件(如训练时的“早停”,验证误差长时间不再下降就停止训练),函数与类,以及 NumPy、scikit-learn、Keras、Conda 几样核心工具。作者建议在隔离的环境里工作,让依赖关系井然有序、实验可以复现。